Marketing mix modeling (MMM) оценивает, какую часть продаж на самом деле принёс каждый канал, включая ТВ и наружную рекламу, и сколько вернёт следующий доллар в каждом из них. Модель работает на агрегированных недельных данных, без cookies и пользовательских идентификаторов, и во многом поэтому к ней снова вернулись. Порог входа - около двух лет чистой недельной истории, в которой бюджеты реально менялись, а на выходе получается оценка с неопределённостью, а не доказательство: доверять ей можно, когда её начинают проверять экспериментами.
Это вводная статья серии из четырёх. Здесь: что такое MMM и нужен ли он вам сейчас. Дальше: Google Meridian на практике, гео-эксперименты в GeoX и GeoLift для проверки модели и Meridian, Robyn и PyMC-Marketing в сравнении для выбора библиотеки.
На какие вопросы MMM отвечает и на какие нет
Лучшее короткое описание задачи до сих пор - список вопросов из статьи Чана и Перри (Google, 2017): какую отдачу дало ТВ в прошлом году, какими будут продажи, если в следующем году потратить больше или меньше, и как разделить бюджет, чтобы продать больше всего.¹ Рабочая MMM даёт четыре вещи:
- Инкрементальный вклад каждого канала. Сколько продаж, заявок или выручки канал добавил сверх базы, которая случилась бы и без него. Сюда входят ТВ, наружная реклама (OOH), радио и спонсорство, которых пользовательская атрибуция не видит вовсе.
- ROI каждого канала, посчитанный от инкрементального вклада, а не от атрибуцированных кликов.
- Кривые отклика. Как вклад канала меняется при росте или снижении бюджета, то есть где канал упирается в насыщение.
- Сценарии бюджета. Что будет с итогом, если перенести деньги между каналами, в пределах тех бюджетов, которые модель уже видела.
Не менее важно, чего она делать не умеет:
| Вопрос | Ответит ли MMM? | Инструмент лучше |
|---|---|---|
| Какие каналы дали дополнительные продажи в прошлом году, включая ТВ и OOH | Да, это её основная задача | - |
| Как разделить бюджет следующего года между каналами | Да, в пределах бюджетов, которые она видела | Крупные сдвиги проверить экспериментом |
| Какой креатив, аудитория или ключевое слово работают лучше | Нет: в недельных итогах по каналу нет такой детализации | A/B-тесты в платформах, атрибуция |
| Что поменять в кампаниях на этой неделе | Нет: модель обновляют в лучшем случае раз в месяц или квартал | Атрибуция, отчёты платформ |
| Доказать, что канал X вызвал эти продажи | Сама по себе нет: это регрессия на исторических данных | Рандомизированные или гео-эксперименты |
| Что будет, если утроить бюджет канала | Плохо: это экстраполяция за пределы данных | Тест с усилением бюджета (heavy-up) |
Пятую строку команды обычно пропускают. Чан и Перри подчёркивают, что MMM - это регрессия на небольшом объёме наблюдательных данных и её результаты корреляционные, а не причинные, за исключением узкого набора условий.¹ Плейбук Google по измерениям говорит то же практическим языком: раз MMM опирается на корреляции, её точность зависит от масштаба, времени и вариации ваших прошлых расходов.² Это не повод отказываться от MMM. Это повод планировать эксперименты рядом с ней с первого дня.
Модель в одной формуле
Большинство современных MMM, включая Meridian, Robyn и PyMC-Marketing, построены на скелете, который Джин и соавторы выписали в статье Google 2017 года:³
Здесь - KPI в неделю t (продажи, выручка, одобренные заявки), - база (свободный член плюс тренд и сезонность: то, что вы продали бы без платной рекламы), - расходы или показы канала c в неделю t, Adstock переносит часть медиа прошлых недель в текущую с коэффициентом затухания , Hill изгибает его в убывающую отдачу с точкой полунасыщения и наклоном , - максимальный эффект канала, - контрольные переменные (цена, промо, праздники, макроэкономика, конкуренты) с коэффициентами , а - шум, который модель не объясняет.
Три свойства, которые стоит держать в голове, прежде чем читать презентацию любого вендора:
- Эффекты медиа складываются. Каждый канал - отдельное слагаемое, поэтому модель и может разложить продажи на базу и каналы. Джин и соавторы прямо оговаривают, что ради простоты синергия между каналами здесь не учитывается.³
- Сначала перенос эффекта, потом насыщение - обычный порядок. Meridian применяет Hill к медиа после adstock, если не переключить настройку,⁴ а Джин и соавторы объясняют, когда лучше обратный порядок: когда бюджет приходит несколькими короткими всплесками.³
- Библиотеки нормируют adstock по-разному. У Джина и соавторов, в Meridian и в PyMC-Marketing (по умолчанию) веса adstock делятся на их сумму, и медиа после adstock остаются в масштабе расходов.³ ⁴ ⁵ Геометрический adstock в Robyn - обычная рекурсивная сумма, которая раздувает итог в 1/(1-θ) раз.⁶ Поэтому одно и то же θ в разных инструментах означает разное, а разницу поглощают β и ec. Сравнивайте между моделями кривые и ROI, но не сырые параметры.
У Джина и соавторов есть и вторая причина читать кривые, а не коэффициенты: очень разные сочетания β, ec и s рисуют почти одну и ту же кривую в пределах наблюдаемых расходов, так что отдельные параметры иногда почти неидентифицируемы, даже когда сама кривая оценена хорошо.³
Adstock: реклама, которая работает после окончания флайта
Идея, что эффект рекламы накапливается и затухает, а не действует только в неделю выхода, восходит к Саймону Бродбенту: термин adstock он ввёл в статье 1979 года «One Way TV Advertisements Work» в Journal of the Market Research Society. Самая простая и до сих пор самая распространённая форма - геометрическое затухание:
- медиа после adstock в неделю t, - расходы этой недели, θ (от 0 до 1) - доля adstock прошлой недели, которая переходит в текущую. Это ненормированная форма, как в Robyn; графики серии используют её, потому что по ней легко следить за числами.
Возьмём один всплеск в 100 в первую неделю и ничего после:
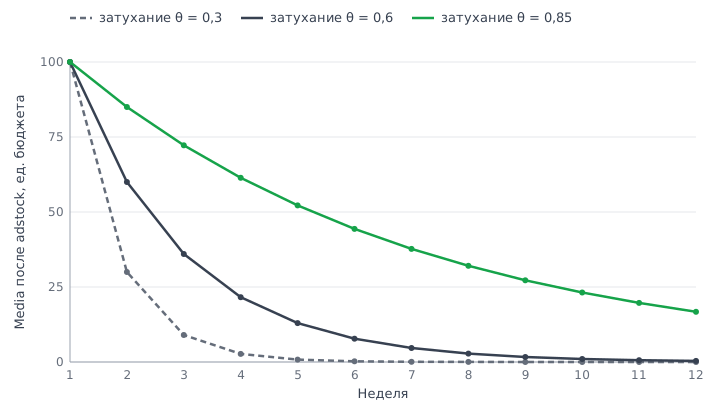
| Неделя | θ = 0,3 | θ = 0,6 | θ = 0,85 |
|---|---|---|---|
| 1 | 100 | 100 | 100 |
| 2 | 30 | 60 | 85 |
| 3 | 9 | 36 | 72,25 |
| 4 | 2,7 | 21,6 | 61,41 |
| 5 | 0,81 | 12,96 | 52,2 |
| 6 | 0,24 | 7,78 | 44,37 |
| Сумма, недели 1-12 | 142,86 | 249,46 | 571,84 |
| Сумма, все недели | 142,86 | 250 | 666,67 |
Каждая неделя сохраняет долю θ от предыдущей, поэтому суммарный эффект всплеска - геометрический ряд:
Здесь 100 - всплеск, а k - номер недели после него: θ = 0,3 даёт 100/0,7 = 142,86, θ = 0,6 даёт 100/0,4 = 250, θ = 0,85 даёт 100/0,15 = 666,67.
Из таблицы следуют два практических вывода. Первый: медленный канал растягивает эффект на месяцы. При θ = 0,85 за 12 недель набирается только 571,84 из 666,67, поэтому модель с коротким окном лагов или тест, прочитанный слишком рано, теряют часть эффекта. Второй: от коэффициента затухания зависит, сколько заслуги канал получит за продажи, случившиеся через недели после остановки рекламы. Поэтому его нужно оценивать, а не вписывать руками.
Для стартовых диапазонов документация Robyn приводит эмпирическое правило по недельным моделям, которые строила её команда: ТВ 0,3-0,8, OOH, пресса и радио 0,1-0,4, digital 0,0-0,3.⁶ Используйте их как границы для prior (априорных распределений) или гиперпараметров, а не как факты о вашем рынке.
Некоторые каналы достигают пика позже. Геометрическое затухание ставит пик в неделю расходов. Для медиа, которым нужно время раскачаться, например длинной ТВ-кампании или запуска бренда, Джин и соавторы предлагают adstock с отложенным пиком (он есть в PyMC-Marketing), а Robyn для той же цели предлагает формы Вейбулла. Проверьте, что поддерживает ваша библиотека, прежде чем навязывать геометрическое затухание всем каналам.
Насыщение: почему второй миллион покупает меньше первого
Второе преобразование описывает убывающую отдачу. Стандартная форма - функция Хилла, которую Джин и соавторы позаимствовали из фармакологии:³
x - медиа (после adstock), ec - точка полунасыщения, уровень, при котором канал даёт половину своего максимального эффекта, s - наклон, задающий форму кривой; результат лежит от 0 до 1 и умножается на β, превращаясь в эффект канала.
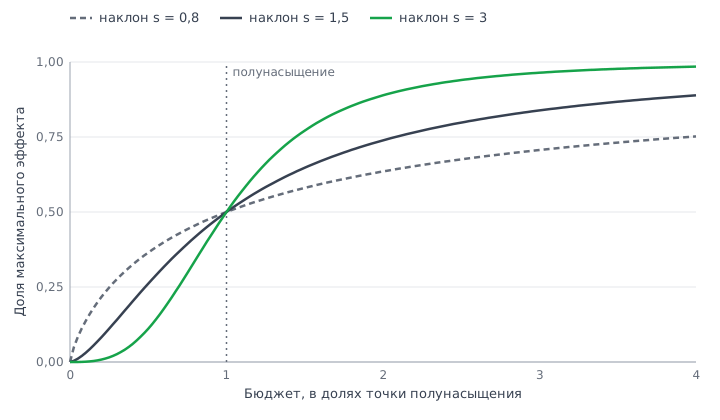
Расчёт при ec = 100 и s = 1, то есть Hill(x) = x / (x + 100):
| Бюджет x | Hill(x) | Расчёт |
|---|---|---|
| 50 | 0,333 | 50 / 150 |
| 100 | 0,5 | 100 / 200 |
| 200 | 0,667 | 200 / 300 |
| 400 | 0,8 | 400 / 500 |
Удвоение бюджета со 100 до 200 поднимает эффект с 0,5 до 0,667: на треть, а не вдвое. Следующее удвоение, до 400, добавляет примерно пятую часть (0,8 / 0,667). В этой таблице весь смысл перераспределения бюджета: тот же доллар стоит больше в канале, который ещё находится на крутом участке своей кривой.
Два замечания из практики. Априорное распределение Meridian по умолчанию предполагает выпуклую вверх кривую для платных медиа, а документация предупреждает, что S-образные кривые могут мешать оптимизации бюджета (на октябрь 2026).⁷ А S-образную форму модель может выучить, только если в истории есть недели с низкими расходами: Джин и соавторы показывают, что когда точка полунасыщения лежит за пределами наблюдаемых расходов, совершенно разные кривые одинаково хорошо описывают данные.³
От данных к решениям: конвейер MMM
От недельных данных к решению по бюджету
Одна регрессия, три способа её читать, проверка экспериментами
Недельные данные
KPI из бэкенда
Бюджет и показы по каналам
Контрольные: цена, промо, сезон
- 2+ года
Преобразования и оценка
Adstock
Насыщение Хилла
Байесовская или ridge-оценка
- проверка на отложенных неделях
Чтение результатов
Декомпозиция
ROI, mROI
Кривые отклика
- интервалы, а не точки
Решение
Сценарии бюджета
Не больше 20% за шаг
Проверка крупнейших ставок
- эксперименты
Результаты экспериментов возвращаются в модель как калибровка.
Цикл повторяется, когда планируют бюджеты: раз в квартал или в год.
- Данные. Недельный KPI, расходы и охват по каналам, контрольные переменные. Во всех проектах MMM, которые я видел, этот шаг занимает большую часть времени.
- Преобразования. Adstock и насыщение для каждого канала, с параметрами, оценёнными по данным, а не заданными вручную.
- Обучение. Meridian и PyMC-Marketing - байесовские: вы задаёте prior и получаете posterior (апостериорное распределение) по каждому параметру. Robyn обучает гребневые (ridge) регрессии, подбирает параметры преобразований оптимизатором и выбирает среди множества моделей-кандидатов и по качеству подгонки, и по критерию правдоподобия, который сравнивает долю эффекта каждого канала с его долей в расходах.⁶ Компромиссы разобраны в статье-сравнении.
- Результаты. Декомпозиция, ROI и предельный ROI, кривые отклика: о них следующий раздел.
- Сценарии бюджета. Оптимизатор переносит деньги между каналами вдоль кривых отклика в заданных вами границах.
- Эксперименты. Каналы с самой широкой неопределённостью и самыми крупными планируемыми сдвигами идут в тест, а результаты возвращаются в модель как калибровка: prior в байесовской модели, отдельная целевая функция калибровки в Robyn.
Как читать результаты
Проверьте модель на неделях, которых она не видела
Прежде чем читать любой ROI, отложите последние недели и проверьте модель на них. На графике смоделированный бренд с тремя каналами, истинный ROI которых известен: регрессию, которой дали истинные формы adstock и насыщения, обучают на 91 неделе и проверяют на последних 13. R² на обучении 0,917, средняя абсолютная ошибка в процентах на отложенных неделях 7,3%.
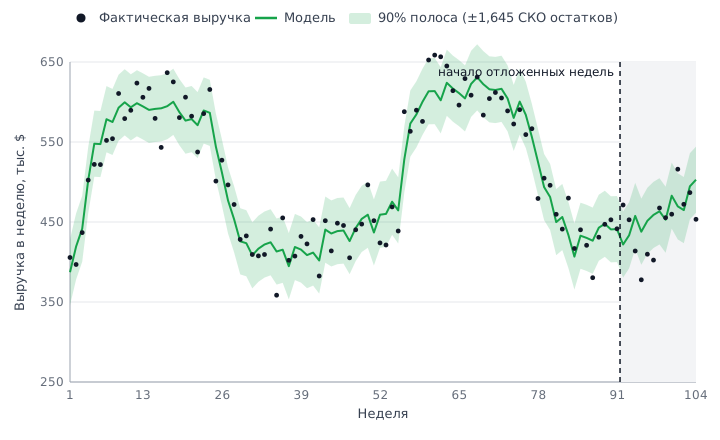
Хорошая проверка на отложенных неделях необходима, но не достаточна. На этих же данных модель не может отделить наружную рекламу от базы, потому что её бюджет почти не меняется: интервал её ROI остаётся от 0,29 до 3,52 против 0,28-4,69 у одного prior. Как это выглядит и что меняет один эксперимент, показано в статье про Meridian.
Декомпозиция: откуда пришли продажи
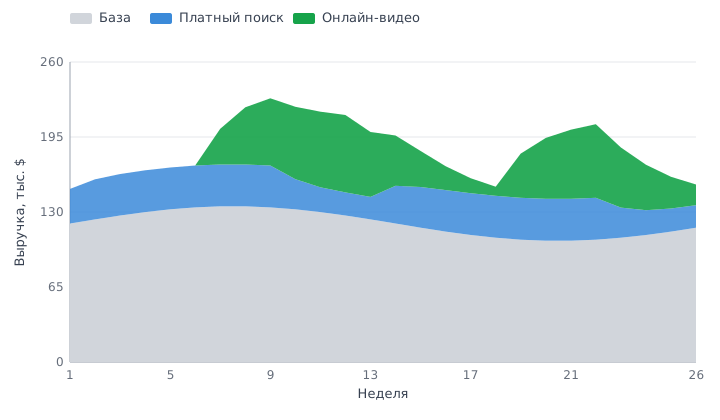
График построен на синтетических данных. За 26 недель модель относит 3120 на базу, 814 на платный поиск и 858 на онлайн-видео (тыс. $), всего 4792. Доля компонента - его вклад, делённый на сумму:
- смоделированная выручка канала (или базы) за период, а сумма берётся по всем компонентам: база = 3120 / 4792 = 65,1%, платный поиск = 814 / 4792 = 17,0%, видео = 858 / 4792 = 17,9%.
Две проверки, которые я делаю на каждой декомпозиции, прежде чем кто-то начнёт обсуждать каналы:
- Правдоподобна ли база? База в 65% означает, что около двух третей выручки за этот период случились бы вообще без платной рекламы. Верить ли в это - вопрос к бизнесу: спросите продажи и финансы, прежде чем принимать цифру. База, которая в какие-то недели уходит ниже нуля, почти всегда означает ошибку в спецификации модели, а не гениальность маркетинга.
- За что модель хвалит поиск? Постоянно включённый поиск, особенно брендовый, собирает спрос, который создали другие каналы и сам бренд. Чан и Перри называют платный поиск и ремаркетинг типичными примерами смещения отбора (selection bias),¹ а плейбук Google называет поиск особенно трудным для измерения в MMM и рекомендует регулярно проверять его экспериментами.²
ROI и предельный ROI
ROI говорит, как канал отработал в среднем. Предельный ROI (mROI) говорит, что сделает следующий доллар. Решения о бюджете принимаются по второму.
- дополнительная выручка при недельном бюджете x, - максимум, который канал вообще способен добавить, ec = 50 - его точка полунасыщения (всё в тыс. $, наклон s = 1); ROI - выручка на доллар уже потраченного, mROI - производная, отдача ещё одного доллара.
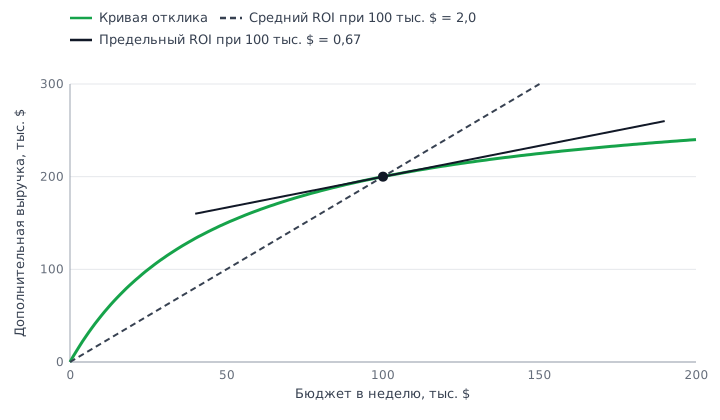
| Бюджет в неделю, тыс. $ | Дополнительная выручка, тыс. $ | ROI | mROI |
|---|---|---|---|
| 25 | 100 | 4,0 | 2,667 |
| 50 | 150 | 3,0 | 1,5 |
| 100 | 200 | 2,0 | 0,667 |
| 150 | 225 | 1,5 | 0,375 |
При 50: выручка = 300 × 50 / 100 = 150, ROI = 150 / 50 = 3,0, mROI = 300 × 50 / 100² = 1,5. При 100: выручка = 300 × 100 / 150 = 200, ROI = 2,0, mROI = 15 000 / 150² = 0,667. Точка, где следующий доллар возвращает ровно доллар:
Приравняв mROI к 1 и решив уравнение относительно x, получаем бюджет безубыточности, здесь 72,5 тыс. $ в неделю.
То есть при 100 тыс. $ в неделю канал показывает здоровый ROI 2,0, а каждый доллар сверх 72,5 тыс. возвращает меньше доллара. Отчёт, где есть только ROI, посоветовал бы и дальше наращивать бюджет. Правило решения: переносить деньги из каналов с низким mROI в каналы с высоким, пока предельная отдача не станет примерно одинаковой; Джин и соавторы формализуют ту же идею как максимизацию прогнозной выручки при фиксированном бюджете.³
Две оговорки. ROI в MMM включает перенос эффекта: Джин и соавторы учитывают и выручку в неделях после периода расходов.³ И эти два числа не одинаково надёжны: Чан и Перри отмечают, что модель может неплохо оценивать предельный ROI рядом с текущими расходами и плохо - средний, потому что средний ROI требует экстраполяции к нулевому бюджету, а такого уровня в данных обычно нет.¹
Интервалы: почему одна точка опасна
Каждое число выше - одна точка. Настоящие модели выдают распределения: posterior в байесовских моделях, бутстреп-интервалы в Robyn. Три причины никогда не показывать точку без интервала:
- Оптимальный микс тоже неопределён. Джин и соавторы показали, что рекомендованный микс имеет большую дисперсию, потому что большую дисперсию имеют оценки параметров, и что подстановка средних параметров в формулу ROI может дать неверный ответ, так как игнорирует совместное движение параметров. Считайте ROI для каждой выборки из posterior и только потом усредняйте.³
- Хорошая подгонка не равна проверке. В примере Чана и Перри пять правдоподобных моделей на одних и тех же данных, все с R² 0,98-0,99, расходились в прогнозе продаж до 50% и рекомендовали противоречащие друг другу распределения бюджета.¹
- Широкие интервалы подсказывают, что тестировать дальше. Плейбук Google рекомендует первыми проверять экспериментами каналы с самыми широкими интервалами.²
Моё рабочее правило: показывать ROI каждого канала вместе с интервалом. Если интервал по каналу накрывает и «сократить», и «удвоить», модель не ответила на вопрос по этому каналу, и именно он - ваш следующий эксперимент.
Что нужно подготовить до старта
- 2 года: минимум недельной истории (Robyn, плейбук Google)
- 3 года: рекомендуется для национальной модели Meridian
- 10 : 1: наблюдений на одну переменную модели (Robyn)
- 4: точки на параметр в примере Meridian на 104 неделях: слишком мало
Источники сходятся в нижней границе. Руководство аналитика Robyn требует минимум два года недельных данных, а при только месячных данных - больше двух лет, например 4-5.⁸ Плейбук Google называет не менее двух лет истории обязательным условием MMM.² Meridian просит минимум два года недельных данных для гео-моделей и три года для национальных, а для месячных данных - не меньше трёх лет.⁹
Почему больше - лучше, объясняет простой подсчёт. Документация Meridian разбирает национальную модель с 12 каналами, 6 контрольными переменными и 8 узлами тренда: 26 параметров на 104 недельных точках - это 4 точки на параметр, что документация называет слишком малым для надёжной оценки, и предлагает три года (156 / 26 = 6 точек на параметр) или гео-модель.¹⁰ Чан и Перри приводят эмпирическое правило 7-10 точек на параметр для устойчивой регрессии и отмечают, что лаг и насыщение требуют 3-4 параметров на канал.¹ Руководство Robyn рекомендует около 10 наблюдений на одну независимую переменную.⁸
Помимо длины истории, чек-лист такой:
- Один KPI с одинаковым определением на весь период. Если в 2024 году «заявкой» считалась отправленная форма, а в 2025-м одобренная заявка, модель увидит структурный разрыв, а не маркетинг. Meridian также требует KPI, который можно суммировать по времени и регионам: штуки, выручка, конверсии, но не доли вроде CTR.⁹
- Бизнес-результат, а не конверсия из рекламной платформы. В банках, страховании и кредитовании результат живёт в core-системе или CRM: одобрения, выдачи, полисы, нередко оформленные офлайн в отделении или колл-центре. Заведите их в недельную таблицу; как их собрать, разобрано в статьях про атрибуцию отделений и лиды без выдач.
- Расходы и охват по каждому каналу за каждую неделю, фактические, а не плановые. Руководство Robyn настаивает на фактических данных и предпочитает метрики контакта, например показы или GRP, если они есть;⁸ Meridian нужны расходы плюс одна метрика контакта по каждому каналу.⁹
- Вариация. Если бюджет канала почти не менялся, модель не отделит его эффект от базы; в руководстве Robyn пример с ТВ-бюджетом, который стоит на месте, пока продажи колеблются.⁸ Паузы, флайты и региональные различия - то, на чём модель учится. Каналы, которые всегда растут вместе (всё вверх в четвёртом квартале), создают ту же проблему.¹
- Контрольные переменные. Цены и промо, процентные ставки для финансовых продуктов, праздники по местному календарю, запуски продуктов, активность конкурентов, макропоказатели.
- Место для данных. Недельная таблица в хранилище, которую пересобирает задание по расписанию, а не таблица, которую кто-то обновляет вручную. См. статью про first-party данные и DWH. Поскольку MMM работает только с агрегированными данными, потеря cookies и пробелы в согласиях не ломают её так, как ломают пользовательский трекинг,² при условии что KPI берётся из вашего бэкенда, а не из конверсий, которые отчитывает платформа; откуда берутся эти пробелы, объясняет статья про Consent Mode v2.
Посчитайте параметры до того, как заказывать модель. Двадцать каналов по 3-4 параметра плюс контрольные переменные и сезонность могут превысить 156 точек, которые дают три года национальных недельных данных. Документация Meridian перечисляет способы: объединить мелкие каналы, убрать почти нулевые, сократить контрольные переменные и узлы, добавить годы, перейти на гео-данные или использовать более сильные prior.
MMM, атрибуция и эксперименты: кто на что отвечает
| Мультиканальная атрибуция (MTA) | Эксперименты на инкрементальность | MMM | |
|---|---|---|---|
| Данные | Пользовательские пути (клики, частично просмотры) | Тестовые и контрольные группы пользователей или регионов | Агрегированные недельные итоги |
| Что измеряет | Заслугу точек касания на путях с конверсией | Причинный инкрементальный эффект в конкретный момент | Смоделированный инкрементальный вклад во времени |
| Каналы | Отслеживаемый digital | Любой канал, который можно отключить или изменить | Все, включая офлайн |
| Скорость | Ежедневно | Недели на тест | Обновление раз в месяц или квартал |
| Главная слабость | Засчитывает продажи, которые случились бы и так | Снимок одного момента, дорого масштабировать | Корреляционная, нужна длинная история |
| Лучше всего для | Ежедневной оптимизации кампаний | Доказательства и калибровки | Распределения бюджета между каналами |
Таблица следует обзору из плейбука Google.² Там же предложен полезный способ держать три инструмента вместе: для digital-каналов с кликами атрибуция обычно даёт щедрую верхнюю границу, эксперименты - консервативную нижнюю, и оценка MMM должна лечь между ними. Если не ложится, сначала проверьте настройку, а потом спорьте о цифрах.
Правила совмещения в плейбуке конкретные:²
- Сравнивайте сопоставимое. Эксперимент должен покрывать ту же агрегацию каналов и ту же метрику, что и модель, и проходить в обычный для бизнеса период.
- Расхождение 5-10% между MMM и экспериментом допустимо. Ниже 10% срочно перекалибровывать не нужно.
- Выше 10% калибруйте модель по эксперименту. В байесовской MMM эксперимент становится prior для ROI; в небайесовской плейбук предлагает множитель: iROAS эксперимента, делённый на ROAS из MMM.
- Сдвигайте не больше 20% бюджета канала за раз по прогнозам MMM, а любое изменение больше 10% по возможности проверяйте экспериментом.
- Не калибруйте целый канал по одному эксперименту. Калибровка должна быть постоянной и охватывать как можно больше каналов.
- Не стремитесь к единому источнику правды. Даже с MMM мирового уровня ежедневную оптимизацию лучше вести по атрибуции.
Один эксперимент - одна задача. Плейбук прямо говорит: один и тот же эксперимент нельзя использовать и для калибровки модели, и для её проверки. Если результат теста ушёл в prior, для проверки обновлённой модели планируйте новый тест.
Руководство IAB от декабря 2025 года говорит о том же со стороны рекламодателя: MMM нужно встраивать в связку с атрибуцией, экспериментами и финансовыми системами, а не держать отдельным отчётом.¹¹ Как спроектировать эти эксперименты, в том числе при малом числе регионов, разобрано в статье про гео-эксперименты.
Когда MMM окупается, а когда нет
Опубликованного порога «достаточно большой компании» нет. Ниже моё суждение из практики, а не правило из какого-либо источника.
- Стоит делать сейчас. Несколько каналов, настоящая история. Четыре и больше каналов с заметными бюджетами, хотя бы один из них атрибуция не видит (ТВ, OOH, радио, спонсорство, размещения в Telegram), два года недельных данных, бюджет решается раз в квартал или год, и есть человек с полномочиями действовать по итогам перераспределения.
- Сначала подготовиться. Каналы есть, данных пока нет. KPI менял определение, расходы лежат в таблицах агентств или результат - офлайн-событие, которого ещё нет в хранилище. Потратьте ближайшие месяцы на недельную таблицу и первый эксперимент.
- Пока рано. Слишком просто или слишком ново. Один-два digital-канала, где эксперименты в платформах и атрибуция ответят дешевле; бизнес-модель, которая принципиально изменилась меньше двух лет назад; или бюджеты, которые весь период стояли на месте.
Мой тест на размер бюджета: возьмите годовой медиабюджет, предположите, что лучшее распределение повысит его эффективность на скромные несколько процентов, и сравните с годовой стоимостью модели, то есть с инженерией данных, временем аналитика, обновлениями и одним-двумя экспериментами. Если первое число не превышает второе с запасом, вложитесь сначала в данные и эксперименты и вернитесь к MMM через год.
Казахстан и СНГ: что меняется
Мало гео-единиц. В Казахстане 17 областей и 3 города республиканского значения (Алматы, Астана, Шымкент), то есть около 20 гео-единиц.¹² Документация Meridian иллюстрирует гео-модель на 105 регионах и 156 неделях.¹⁰ Гео-модели выигрывают в точности за счёт большого числа регионов и различий в расходах между ними,¹³ а при 20 очень неравных единицах, где у большинства потребительских брендов, с которыми я работаю, Алматы и Астана намного крупнее остальных, этот выигрыш ограничен. Гео-эксперименты упираются в ту же стену: GeoLift рекомендует больше 20 гео-единиц,¹⁴ и Казахстан находится ровно на этой границе.
Что я с этим делаю:
- Начинаю с национальной недельной модели и вкладываюсь в хорошо обоснованные prior и эксперименты, а не в гео-детализацию.
- Перехожу на гео-уровень, только когда региональны обе стороны: KPI по региону клиента или отделения и расходы, которые действительно закупались по регионам. Сан и соавторы показывают, что гео-оценки ухудшаются по мере того, как всё больше медиапеременных восстанавливается из национальных данных,¹³ а национальные кампании на ТВ, в Яндексе или Telegram, разнесённые по регионам пропорционально населению, - именно такое восстановление.
- Для экспериментов беру города, где это позволяет KPI, провожу тесты дольше и использую подобранные рынки (matched markets) или синтетический контроль вместо простого случайного разбиения; Алматы и Астану рассматриваю отдельно, чтобы один из них не оказался в тестовой группе в одиночку. Подробности в статье про гео-эксперименты.
Локальный набор каналов. Обычно это Google, Meta, TikTok, Яндекс, Telegram, OOH и ТВ. Работа с данными по каналам разная: ТВ приходит недельными GRP от медиаагентства; размещения в Telegram-каналах, купленные напрямую, часто существуют только в виде счетов и ссылок на посты, поэтому собирайте стоимость и просмотры по каждому посту и сворачивайте в недели; OOH часто покупается длинными ровными контрактами, и модели почти не на чем учиться.
Офлайн-результаты в банках и суперприложениях. Для банков, страховщиков и суперприложений целевое действие, будь то одобренный кредит, выдача, активированная карта или подписанный полис, часто происходит в отделении, в колл-центре или внутри приложения. MMM с этим справляется хорошо, потому что ей нужны только недельные итоги из core-системы, но кто-то должен построить эту недельную выгрузку. См. статьи про атрибуцию отделений и продвижение суперприложения с Firebase и tROAS.
Типичные ошибки
Считать брендовый поиск драйвером роста
Брендовый поиск собирает спрос, который создали ТВ, OOH и сарафанное радио, и модель может отдать ему чужую заслугу. Проверьте поиск экспериментом, прежде чем переносить в него деньги со слов модели.
Перераспределять бюджет по среднему ROI
У канала с ROI 2,0 предельный ROI может быть 0,67. Двигайте бюджет по mROI и кривым отклика; средний ROI - для отчёта о прошлом.
Верить одной модели, потому что она хорошо подогнана
Одинаково хорошо подогнанные модели могут расходиться в прогнозе продаж до 50%. Смотрите на интервалы, сравнивайте варианты модели и считайте высокий R² минимальным требованием, а не проверкой.
Спрашивать о бюджетах, которых модель не видела
Удвоить канал или выключить его - это экстраполяция. Сдвигайте не больше 20% бюджета канала за раз и перед крупными шагами проводите тест с усилением или отключением (holdout).
Моделировать лиды вместо бизнес-результата
Отправленные формы легко собрать и легко накрутить. Если бизнес зарабатывает на одобрениях или выдачах, моделируйте их, даже если для этого придётся каждую неделю выгружать данные из core-системы.
Следующий шаг
Если вы решаете прямо сейчас, начните со сбора недельной таблицы за последние два года: KPI, расходы и охват по каналам, контрольные переменные. То, как далеко вы продвинетесь за две недели, расскажет о вашей готовности больше любой демонстрации вендора, а когда таблица будет готова, продолжение - в статье про Meridian.
Источники
¹ Challenges and Opportunities in Media Mix Modeling (Chan, Perry, 2017) - Google Research
² Modern Measurement Playbook, 2024 edition - Google
³ Bayesian Methods for Media Mix Modeling with Carryover and Shape Effects (Jin et al., 2017) - Google Research
⁴ Model specification - Meridian, Google for Developers
⁵ GeometricAdstock - PyMC-Marketing API reference
⁶ Features: adstock, saturation and model selection - Robyn, Meta
⁷ Media saturation and lagging - Meridian, Google for Developers
⁸ Analyst's guide to MMM - Robyn, Meta
⁹ Collect and organize your data - Meridian, Google for Developers
¹⁰ Amount of data needed - Meridian, Google for Developers
¹¹ Modernizing MMM: Best Practices for Marketers - IAB
¹² Administrative-territorial units of the Republic of Kazakhstan (July 1, 2023) - Bureau of National Statistics
¹³ Geo-level Bayesian Hierarchical Media Mix Modeling (Sun et al., 2017) - Google Research
¹⁴ GeoLift - Meta, GitHub
Частые вопросы
Сколько времени занимает построение первой MMM?
По моему опыту, само моделирование - короткая часть: больше всего календарного времени уходит на то, чтобы собрать, очистить и согласовать два года недельных данных по KPI, расходам и контрольным переменным. Когда недельная таблица готова, первая внятная модель занимает недели. Гео-эксперимент для её проверки добавляет ещё: по руководству Google GeoX на тест от планирования до завершения закладывается 7-14 недель.
Можно ли строить MMM на месячных данных?
Можно, но нужна более длинная история: руководство Robyn советует больше двух лет, например 4-5, а Meridian просит минимум три года месячных данных. Месячные данные дают 12 точек в год вместо 52, поэтому модель может позволить себе гораздо меньше параметров, а документация Meridian предупреждает о проблемах со сходимостью и широких интервалах. Если недельные данные где-то есть, а в рекламных платформах и core-системах они обычно есть, восстановите историю по неделям.
Если у нас есть MMM, нужна ли ещё атрибуция?
Да. Плейбук Google прямо говорит, что даже MMM мирового уровня не заменяет атрибуцию для ежедневной оптимизации. MMM обновляется раз в месяц или квартал на уровне каналов, атрибуция отвечает ежедневно на уровне кампаний и ключевых слов. Распределяйте бюджет между каналами по MMM и экспериментам, а управляйте внутри каналов по атрибуции, в идеале откалиброванной экспериментами.
Как часто обновлять модель?
Моя настройка по умолчанию: обновление на новых данных раз в квартал и полная пересборка раз в год или после крупного изменения в бизнесе или наборе каналов. Между обновлениями двигайте не больше 20% бюджета канала за раз и продолжайте эксперименты, чтобы у следующего обновления была свежая калибровка. Если обновление на трёх новых месяцах данных резко меняет ROI канала, это тревожный сигнал, а не новость.
Влияют ли на MMM потеря cookies, ITP и баннеры согласия?
Напрямую нет: MMM работает с агрегированными недельными итогами и не нуждается в пользовательских данных, и именно поэтому плейбук Google называет её более устойчивой к будущим изменениям. Подвох в KPI. Если он берётся из конверсий рекламных платформ или GA4, он наследует их пробелы в согласиях и трекинге, и изменение доли согласий выглядит как изменение продаж, поэтому берите KPI из своего бэкенда или core-системы.
Узнаёте свою воронку?
Две недели, фиксированный скоуп, доступы только на чтение. Находки и роадмап на 90 дней остаются у вас в любом случае.