Если ваши аналитики работают на Python и у вас есть хотя бы два года недельных данных по расходам и KPI в разрезе регионов, начинайте с Meridian от Google. Если нужна структура, которой в Meridian нет (своя схема pooling между регионами, эффекты медиа, меняющиеся во времени, или lift-тесты как данные), берите PyMC-Marketing. Robyn от Meta по-прежнему быстрее всех доводит R-команду до национальной модели, но в его основной ветке нет коммитов с 27 июня 2025 года, так что относитесь к нему как к замороженному ПО. А если в команде некому отвечать за priors и диагностику, ни один из трёх не подходит: покупайте управляемый сервис и оставьте у себя одного человека, который сможет его проверять.
Это сравнительная статья. Если сначала нужны основы (adstock, насыщение, средний ROI против маржинального), начните с того, что такое marketing mix modeling; пошаговый разбор Meridian есть в отдельном гайде.
Короткий ответ по ситуациям
Карточки ниже - мои рекомендации на основе фактов из остальной статьи. Это суждение, а не рейтинг.
- Python-команда, данные по регионам. Meridian. Недельные расходы и KPI по регионам за 2+ года, медиа с перевесом в Google, планы на гео-эксперименты. Вы получаете байесовскую модель с иерархией по регионам, priors на ROI и прямой путь от результатов Meridian GeoX к этим priors. Заложите GPU.
- R-команда, национальные данные, сроки. Robyn с зафиксированной версией. Автоматический поиск гиперпараметров даёт набор национальных моделей-кандидатов без ручного задания priors. Зафиксируйте CRAN 3.12.1 в контейнере: в main нет коммитов с июня 2025, и то, что сломается, никто не починит.
- Своё байесовское моделирование. PyMC-Marketing. Вы хотите сами выбрать pooling между регионами, дать эффектам медиа меняться во времени, использовать adstock с отложенным пиком или передать lift-тесты в функцию правдоподобия. Нужен человек, свободно работающий с PyMC.
- Нет команды data science. Управляемый сервис. Любому из трёх нужен владелец данных, priors, диагностики и обновлений. Если его нет, покупайте сервис, а конвейер данных и журнал экспериментов держите у себя.
- Всё ещё на LightweightMMM. Мигрируйте. Репозиторий в архиве, Google пишет, что он больше не поддерживается. Преемник от Google - Meridian; PyMC-Marketing - альтернатива, если хотите остаться ближе к коду.
Почему «медиа с перевесом в Google» указывает на Meridian, если сама модель не зависит от каналов? Преимущество в экосистеме вокруг неё: GeoX проектирует гео-эксперименты, результаты которых напрямую становятся priors в Meridian, Scenario Planner даёт маркетологам сценарии бюджета без кода, а у Google есть программа сертифицированных партнёров Meridian.¹ Математику это не меняет. Меняет то, сколько помощи можно получить.
Состояние на октябрь 2026
- 2.1.0: Meridian, релиз 17.09.2026
- 1.2.0: PyMC-Marketing, релиз 29.09.2026
- 3.12.1: Robyn на CRAN, релиз 02.07.2025
- 15 месяцев: без коммитов в основной ветке Robyn (с 27.06.2025 по 05.10.2026)
| Meridian | Robyn | PyMC-Marketing | LightweightMMM | |
|---|---|---|---|---|
| Разработчик | Meta Marketing Science | PyMC Labs | ||
| Последняя версия | 2.1.0 | 3.12.1 на CRAN | 1.2.0 | нет, архив |
| Дата релиза | 17.09.2026 (PyPI 25.09.2026) | 02.07.2025; последний тег на GitHub v3.12.0 от 19.12.2024 | 29.09.2026 | нет |
| Лицензия | Apache-2.0 | MIT | Apache-2.0 | нет |
| Язык | Python 3.11-3.13 | R; Python-порт robynpy 0.3.6 в статусе beta | Python 3.12 и новее | Python |
| Признаки поддержки | 2.0.0 и 2.1.0 вышли с разницей в две недели в сентябре 2026 | Нет коммитов в main с 27.06.2025; объявления о прекращении поддержки нет | 1.0.0, 1.1.0 и 1.2.0 вышли в августе и сентябре 2026 | Репозиторий в архиве, не поддерживается |
Meridian 2.0.0 (02.09.2026) переключил вычислительный бэкенд по умолчанию с TensorFlow на JAX и добавил калибровку priors через эксперименты на инкрементальность, например Meridian GeoX; 2.1.0 (17.09.2026) добавил в спецификацию модели декларативный словарь: диапазоны дат, спецификации калибровки и holdout стали именованными объектами.² PyMC-Marketing 1.0.0 (07.08.2026) объявлен стабильным API, переведён на PyMC 6, а многомерная модель стала классом MMM по умолчанию;³ 1.2.0 вышел 29.09.2026.⁴
С Robyn сложнее. CRAN 3.12.1 датирован 02.07.2025,⁵ последний релиз с тегом на GitHub - v3.12.0 от декабря 2024, а в основной ветке нет коммитов с 27.06.2025, хотя пользователи продолжают открывать issues в 2026 году.⁶ Объявления о прекращении поддержки нет, так что «заморожен» - это мой вывод по активности, а не официальная позиция. Python-порт robynpy сам называет себя «LLM-translated Beta», он переведён с R-версии 3.11.1.⁷ Замороженное ПО работает, пока не сдвинется какая-нибудь зависимость, а Robyn стоит на glmnet, Prophet, nloptr и reticulate в R плюс Nevergrad в Python. Если выбираете его, замораживайте всё окружение в контейнере.
LightweightMMM, предыдущая байесовская MMM от Google, в архиве: в README сказано, что Google выпустил Meridian 29 января 2025 года и LightweightMMM больше не поддерживается.⁸ Если вы ещё на нём, планируйте миграцию сейчас.
Два способа оценить одну и ту же модель
Все три фреймворка оценивают один каркас: KPI равен baseline плюс преобразованные медиа плюс контрольные переменные плюс шум. Различаются они тем, как подбирают параметры и что понимают под неопределённостью, и это различие определяет каждую цифру ROI, которую вы покажете руководству.
Robyn: ridge-регрессия внутри многокритериального поиска
Robyn оценивает аддитивную линейную модель:⁹
Здесь - KPI в неделю t, - расходы канала j после adstock, - его кривая насыщения Hill, - коэффициент канала, для платных медиа он ограничен неотрицательными значениями; - компоненты Prophet (тренд, сезонность, праздники) и другие контекстные переменные с коэффициентами ; - шум.
При заданных преобразованиях коэффициенты считает glmnet с параметром смешивания alpha, равным 0, то есть чистая ridge-регрессия:⁶
N - число недель в обучающем окне, - преобразованный регрессор, - сила штрафа. Штраф сжимает коэффициенты к нулю, и коррелированные каналы не могут принять экстремальные значения. Документация Robyn отмечает, что ridge эквивалентна байесовской регрессии с нормальным prior на коэффициенты. Отличие от байесовских инструментов в том, что этот prior задан через , а не записан явно, и его форму вы не видите.
Ridge - это внутренний цикл. Внешний цикл - Nevergrad, безградиентный оптимизатор Meta, который предлагает гиперпараметры преобразований: для каждого канала затухание adstock (или два параметра Weibull) и два параметра Hill, плюс и долю данных для обучения. Десять каналов с геометрическим adstock - это уже 32 гиперпараметра. Документация требует минимум 2 000 итераций и 5 trials.⁹ Каждый кандидат оценивается по двум целевым функциям, по трём при калибровке экспериментами:
NRMSE - ошибка прогноза: среднеквадратичная ошибка, делённая на размах KPI. При включённой валидации по времени код берёт NRMSE на валидационном периоде.
DECOMP.RSSD, которую Robyn называет бизнес-ошибкой, сравнивает , долю канала j в общем эффекте платных медиа, с , его долей в платных расходах, по множеству платных каналов . По умолчанию значение ещё умножается на единицу плюс долю платных каналов с нулевым эффектом, и модели, «выключающие» каналы, штрафуются.
MAPE.LIFT появляется только при калибровке: - инкрементальный результат эксперимента m, - вклад протестированного канала по модели за те же даты.
Дальше Robyn оставляет модели, которые никто не обходит одновременно по NRMSE и DECOMP.RSSD, то есть фронт Парето. При калибровке он сначала оставляет только 10% моделей с наименьшим MAPE.LIFT. Затем кластеризует кандидатов методом k-means, выбирает по одному победителю в кластере и добавляет bootstrap-интервал 95% для ROAS каждого канала внутри кластера. На выходе несколько правдоподобных моделей, и выбирать среди них - ваша задача.
Почему DECOMP.RSSD вызывает споры
Представим, что поиск довёл DECOMP.RSSD до нуля, то есть для каждого канала. Пусть - эффект канала j, - его суммарные расходы, а E и C - итоги по платным каналам:
Тогда у каждого канала одинаковый ROAS, равный среднему по портфелю. В реальных запусках ноль не достигается, но давление всегда направлено туда: канал с 30% платных расходов подтягивается к 30% платного эффекта, что бы ни говорили данные. Документация Robyn сама называет метрику спорной из-за схождения ROAS медиа.⁹
Аргумент в её защиту честный: регрессия без штрафа на коррелированных каналах может отдать весь эффект одному из них, и DECOMP.RSSD отсекает такие экстремальные декомпозиции. Для вас у неё три практических последствия:
- Настоящие лидеры и настоящие аутсайдеры подтягиваются к среднему, и разница между каналами выглядит меньше, чем есть.
- Аллокатор бюджета работает на этих сжатых кривых, поэтому рекомендуемые перераспределения осторожнее, чем позволили бы сами данные.
- Канал, который действительно ничего не даёт, сложно обнаружить: штраф за нулевой эффект работает против этого.
Я читаю DECOMP.RSSD как prior «все каналы одинаково эффективны», применённый ко всему поиску и нигде не записанный. С версии 3.10.5 целевым функциям можно задать веса, а настоящий противовес - калибровка экспериментами через MAPE.LIFT.
Meridian и PyMC-Marketing: prior, умноженный на правдоподобие
Оба фреймворка байесовские. Вместо поиска одной лучшей точки они описывают каждый параметр распределением вероятностей:
- все параметры модели, - prior (то, во что вы верите до данных), - правдоподобие (насколько вероятен наблюдаемый KPI при заданных параметрах), - posterior. Оба инструмента сэмплируют posterior алгоритмом NUTS (No-U-Turn Sampler), поэтому любой результат, от ROI канала до оптимального бюджета, идёт с credible interval: диапазоном, в котором лежит, например, 90% вероятности posterior. Meridian по умолчанию показывает 90%-ные интервалы.
Основное уравнение Meridian без блоков органики, немедийных факторов и reach and frequency:¹⁰
g - регион, t - неделя, - общий для регионов эффект времени, - intercept региона, z - контрольные переменные с коэффициентами , x - медиа канала i с затуханием (в документации оно обозначено ), точкой полунасыщения и наклоном , L - максимальный лаг, - эффект канала i в регионе g. Параметры adstock и Hill у канала общие для всех регионов, а эффект у каждого региона свой, он распределён вокруг значения канала:
- типичный логарифм эффекта канала, - насколько регионы могут от него отклоняться. Это частичный pooling: маленькие регионы «занимают силу» у больших.
Главное отличие - где стоит prior. По умолчанию Meridian задаёт его на ROI, а не на , и выводит коэффициент из него:¹¹
- инкрементальный результат канала i, - его стоимость. У prior по умолчанию медиана и среднее , а его центральный 95%-ный интервал, , идёт примерно от 0,21 до 7,1. Диапазон ROI можно обсудить с руководителем маркетинга; коэффициент на медиа, пересчитанные на душу населения и нормированные на медиану, обсудить нельзя. Именно поэтому эксперименты в Meridian подключаются легко, это видно в разделе о калибровке. Другие типы prior: маржинальный ROI, доля вклада и сам коэффициент.
PyMC-Marketing записывает тот же каркас для одного ряда или для любого набора измерений, например регионов:¹²
- преобразование adstock и насыщения для канала m, - контрольные переменные, сезонность Фурье и события, - коэффициент канала, - масштаб шума. По умолчанию priors заданы на коэффициенты на данных, отмасштабированных по максимуму модуля, например Normal(0, 2) для intercept и контрольных переменных, и заменить можно любой prior, включая функцию правдоподобия. С версии 1.0.0 есть и мультипликативные модели (log и log-log).³
Что это значит на практике
- В Robyn вы выбираете среди моделей. Допущения спрятаны в границах гиперпараметров, ridge-штрафе и DECOMP.RSSD, а неопределённость, которую вы видите, - это bootstrap внутри кластера плюс разброс по фронту Парето, а не posterior.
- В Meridian или PyMC-Marketing вы получаете одну модель с явными priors и интервалом на каждой цифре. Когда данные слабые, posterior остаётся близко к prior, поэтому всегда сравнивайте их; в Meridian это делают health checks.
- Ни один подход не снимает главную проблему. Чан и Перри из Google показали пять моделей с R² 0,98-0,99 и MAPE 6-8%, чьи прогнозы продаж расходились до 50%, а рекомендации по бюджету противоречили друг другу.¹³ Хорошая подгонка не доказывает декомпозицию. Спор решают эксперименты.
Adstock и насыщение: сравнение
| Meridian | Robyn | PyMC-Marketing | |
|---|---|---|---|
| Формы adstock | Геометрическая (по умолчанию), биномиальная с 1.2.0 | Геометрическая, Weibull CDF, Weibull PDF | Геометрическая, с задержкой (delayed), Weibull PDF, Weibull CDF, биномиальная, без adstock, своя |
| Нормировка весов | Да | Нет: геометрическая даёт в сумме 1 / (1 - θ) | Да, по умолчанию |
| Отложенный пик | Нет | Да, Weibull PDF | Да, delayed adstock и Weibull PDF |
| Окно переноса | max_lag, по умолчанию 8 | Весь ряд для геометрической | l_max, задаёте вы |
| Насыщение | Hill; наклон зафиксирован на 1 для обычных каналов; у каналов reach and frequency насыщение по частоте | Hill с alpha (форма) и gamma (точка перегиба) | Logistic, Hill, Michaelis-Menten, tanh, root, log, своя |
| Порядок | Сначала adstock, потом Hill, можно поменять | Сначала adstock, потом Hill | Сначала adstock, потом насыщение, можно поменять |
Источники: документация Meridian,¹⁴ документация Robyn⁹ и код PyMC-Marketing.¹²
Строка про нормировку важнее, чем кажется. Геометрический adstock в Robyn рекурсивный:
- расходы в неделю t, - доля, переходящая на следующую неделю. Разовые 100 при превращаются в 100, 60, 36, 21,6, 12,96, 7,78 и так далее, в сумме 100 / (1 - 0,6) = 250. Meridian и PyMC-Marketing делят на сумму весов:
L - максимальный лаг, - вес на лаге l, для геометрического затухания ; биномиальная альтернатива в Meridian: . Здесь те же 100 остаются 100 в сумме и только распределяются во времени. Коэффициенты Robyn и Meridian для «одного и того же» канала поэтому изначально в разных масштабах, и это ещё одна причина никогда не сравнивать параметры между инструментами.
Биномиальные веса убывают с лага 0 так же, как геометрические, только медленнее, поэтому Meridian не может описать эффект с пиком через несколько недель после расходов.¹⁴ Weibull PDF в Robyn (shape больше 2 сдвигает пик) и delayed adstock в PyMC-Marketing могут. Для кредита, который выдают через несколько недель после заявки, это важно; подробнее в разделе про Казахстан.
Насыщение во всех трёх построено на кривой Hill:
x - расходы после adstock, ec - точка полунасыщения (расходы, при которых канал даёт половину максимального эффекта), s - наклон. В Robyn наклон задаётся параметром alpha, а ec - через gamma, и смысл gamma поменялся в v3.12.0. Начиная с 3.12.0:⁶
До 3.11.1 включительно:
- расходы после adstock в неделю t. В старом определении ec лежала между минимумом и максимумом расходов после adstock, теперь это доля от максимума. Одно и то же gamma даёт разные кривые в двух версиях. Robyn рекомендует alpha от 0,5 до 3 и gamma от 0,3 до 1.
Meridian фиксирует s = 1 для обычных каналов, и все кривые получаются вогнутыми. При ec = 100 расходы 50, 100, 200 и 400 дают 0,333, 0,5, 0,667 и 0,8 от максимума (x / (x + 100)), то есть каждое удвоение добавляет меньше. Причина практическая: на вогнутых кривых оптимизатор бюджета находит глобальный оптимум. Цена в том, что обычный канал никогда не покажет порог, S-образную форму, где первые деньги почти ничего не дают. Если вы считаете, что ТВ работает только после минимального веса, это можно выразить через alpha больше 1 в Robyn или Hill в PyMC-Marketing. Исключение в Meridian - каналы reach and frequency: у них оцениваемая кривая Hill применяется к частоте и умножается на охват.¹⁰
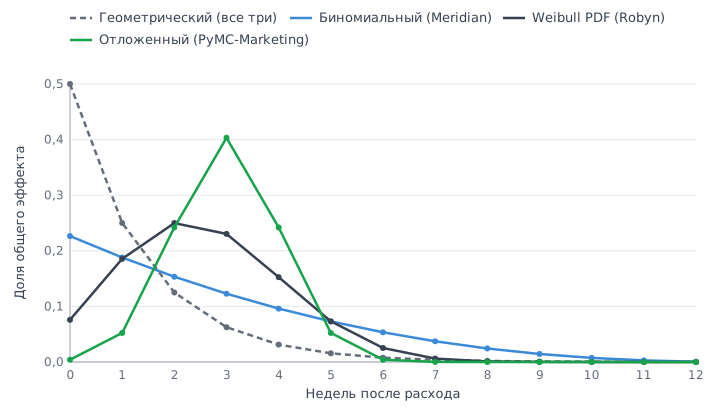
Геометрическое затухание есть во всех трёх. Meridian добавляет биномиальное затухание, которое оставляет больше веса поздним неделям, Robyn - Weibull PDF, который может пикнуть после недели расхода, а PyMC-Marketing - отложенный adstock, где пик задаётся параметром. С параметрами на графике Weibull PDF пикует через 2 недели после расхода, а отложенный adstock через 3.
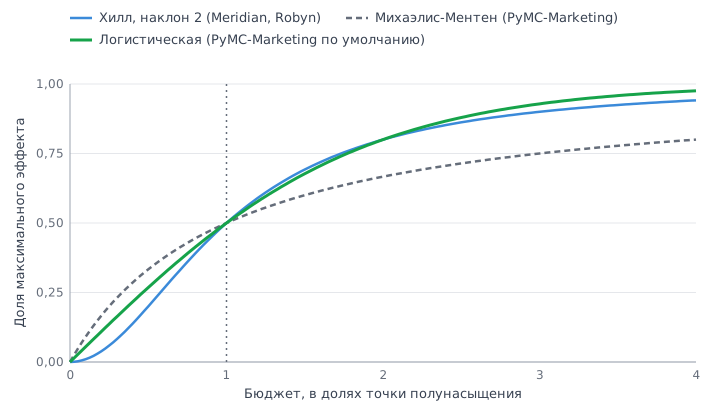
Приведённые к одной точке полунасыщения, кривые совпадают в ней и расходятся в остальном: при вдвое большем бюджете Хилл с наклоном 2 и логистическая кривая дают 0,80 от максимума, а Михаэлис-Ментен 0,67. Ниже этой точки Хилл с наклоном 2 стартует плоско - это пороговый эффект, которого вогнутая кривая показать не может.
Калибровка экспериментами: три разных механизма
Здесь инструменты различаются сильнее всего, и если вы проводите эксперименты, выбирать стоит именно по этому разделу. Сквозной пример - гео-тест из гайда по гео-экспериментам: heavy-up, который добавил 20 тыс. $ сверх обычных расходов за четыре недели и дал 33,2 тыс. $ инкрементальной выручки, iROAS 33,2 / 20 = 1,66. Heavy-up хорош как пример именно потому, что три инструмента обращаются с ним по-разному.
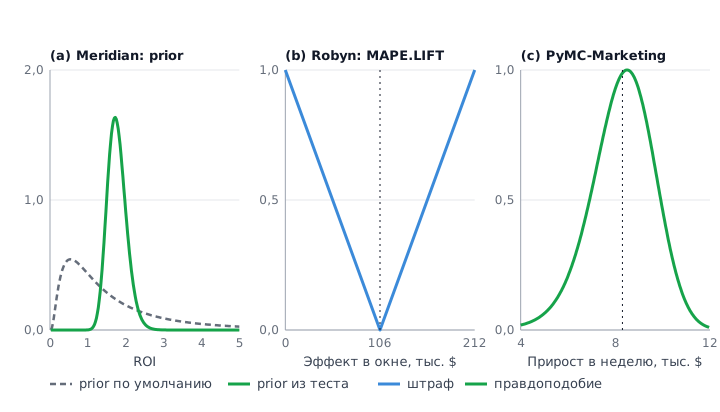
График даёт каждому фреймворку тот эксперимент, под который он устроен. Prior на ROI в Meridian и калибровке Robyn нужен контрфактический сценарий с нулевыми расходами, поэтому они получают go-dark-тест из статьи про Meridian: видео выключено на четыре недели, не потрачено 60 тыс. $, ROI 1,77 со стандартной ошибкой 0,25. Meridian делает из него prior: логнормальное распределение с μ = 0,561 и σ = 0,141 в логарифмической шкале. Robyn берёт выручку, которую потерял тест, 106,2 тыс. $, и штрафует модели пропорционально тому, насколько их эффект видео за окно теста отходит от неё. PyMC-Marketing сравнивает две точки на своей кривой отклика, поэтому может принять heavy-up из статьи про гео-эксперименты как данные: правдоподобие с пиком рядом с измеренным недельным приростом.
Meridian: эксперимент становится prior на ROI
Поскольку prior задан на ROI, тест против нулевых расходов (дизайн holdback или go-dark) переносится напрямую: центр prior на ROI канала ставится на измеренный iROAS, ширина задаётся стандартной ошибкой теста. Вспомогательные функции строят LogNormal по среднему и стандартному отклонению. С версии 2.0.0 это делает CalibrationBuilder по результату Meridian GeoX (инкрементальный эффект на доллар, его стандартное отклонение, обычные расходы и даты) и расширяет prior на известные несоответствия:¹¹
- стандартная ошибка эксперимента, каждое добавляет дисперсию: , когда расходы в тесте отличаются от обычных расходов канала, для старых тестов, , когда тест короче окна переноса, для вашей собственной оценки. Для давности используется период полураспада 52 недели:
a - возраст эксперимента в неделях. Тест годичной давности получает и , и это одно уже расширяет в раза.
Документация прямо говорит, что единой формулы перевода эксперимента в prior нет, и описанная там ловушка, эксперимент, у которого контрфактический сценарий не нулевые расходы, - ровно наш пример: контрфакт MMM - нулевые расходы, а heavy-up измеряет отдачу от дополнительных расходов сверх обычного уровня. CalibrationBuilder исходит из контрфактического сценария с нулевыми расходами. На вогнутой кривой, а кривые Meridian для обычных каналов вогнутые, средняя отдача от нуля не меньше отдачи от любого прироста сверх текущего уровня, поэтому 1,66 ближе к нижней границе ROI канала, чем к его центру. Для heavy-up я использую результат для нижней части prior на ROI или как свидетельство для prior на mROI, а не ставлю центр prior на ROI в 1,66.
Две оговорки на октябрь 2026. Открытый пакет GeoX сейчас считает только оценщик time-based regression (TBR), хотя в его статье описаны и методы синтетического контроля.¹⁵ А в changelog Meridian есть ещё не выпущенное исправление, которое приводит калиброванные priors на ROI на бэкенде JAX в соответствие с TensorFlow, так что в 2.1.0 два бэкенда могут расходиться.²
Robyn: эксперимент становится третьей целевой функцией
Вы передаёте таблицу с каналом, датами начала и конца, абсолютным приростом, расходами, уровнем доверия, метрикой и областью калибровки. MAPE.LIFT сравнивает прирост с вкладом этого канала по модели за те же даты, и до фронта Парето доходят только 10% моделей, ближайших к нему. Гайд для аналитиков прямо говорит, что Robyn принимает только точечную оценку,¹⁶ поэтому тест с узким интервалом и тест с огромным тянут одинаково сильно. Настройка области решает, учитывается ли перенос эффекта за пределы окна теста («total») или нет («immediate»). Robyn принимает результаты conversion lift и гео-экспериментов, например из GeoLift от Meta.
Такое сравнение подходит для дизайна с holdout, где прирост равен всему вкладу канала, и именно такой пример приводит гайд. Наш heavy-up измерил только прирост от дополнительных 20 тыс. $. Если внести его как есть, 33,2 сравнят со всем вкладом канала за четыре недели и потянут этот вклад вниз, поэтому heavy-up нужно пересчитать, прежде чем отдавать Robyn, или не использовать вовсе.
PyMC-Marketing: эксперимент становится данными
add_lift_test_measurements принимает по каждому каналу, а при желании и по каждому региону, уровень расходов до теста x, дополнительные расходы , измеренный прирост и его стандартное отклонение . Документация описывает lift-тест как две точки на кривой насыщения канала, и модель добавляет слагаемое в правдоподобие:¹⁷
h - кривая насыщения канала вместе с коэффициентом, поэтому posterior должен объяснить измеренный прирост формой кривой между x и , с весом по точности теста. Это единственный из трёх механизмов, рассчитанный на heavy-up, но с оговоркой: обе точки лежат на недельной кривой модели для одного региона, а метод не суммирует прогнозы по окну теста. Поэтому итоги за окно сначала нужно пересчитать. Для 4-недельного heavy-up из этой серии это = 20 / 4 = 5, = 33,2 / 4 = 8,3 и = 5,24 / 4 ≈ 1,31 (тыс. $ в неделю), а x - обычные недельные расходы. Так можно делать, только если расходы шли ровно и тест был длинным по сравнению с переносом эффекта канала, а перенос, пришедший после теста, в не попадает. Пересчёт подробно разобран в статье про гео-эксперименты. С версии 1.0.0 add_cost_per_target_calibration добавляет нормальное правдоподобие на стоимость целевого действия или ROAS канала за период.³
| Meridian | Robyn | PyMC-Marketing | |
|---|---|---|---|
| Эксперимент входит как | Prior на ROI канала | Третья целевая функция, MAPE.LIFT | Дополнительное слагаемое правдоподобия |
| Учитывается неопределённость эксперимента | Да, задаёт ширину prior | Нет, только точечная оценка | Да, σ в правдоподобии |
| Что ограничивает | Уровень ROI | Вклад за даты теста | Кривую насыщения между двумя уровнями расходов |
| Естественный дизайн теста | Holdback или go-dark, контрфакт с нулевыми расходами | Holdout, прирост равен вкладу канала | Heavy-up или любой тест с двумя уровнями расходов |
| Эксперименты по регионам | Через prior канала | Нет региональной модели | Да, по колонке на каждое измерение модели |
В плейбуке Google по измерениям есть правило, которое работает с любым из трёх: расхождение 5-10% между MMM и экспериментом допустимо, больше 10% - калибруйте, а калибровка целого канала по одному эксперименту названа ошибкой.¹⁸
Регионы, меняющиеся во времени эффекты и baseline
Meridian по умолчанию иерархический по регионам, как показано выше. KPI моделируется на душу населения, каналы, закупаемые только на всю страну, распределяются по регионам пропорционально населению, а эффект времени строится из узлов (knots): значений в выбранные недели с линейной интерполяцией между ними. В гео-модели по умолчанию один узел на каждую неделю, это работает, потому что эффект времени общий для всех регионов; в национальной модели по умолчанию один узел, и сезонность должна прийти из дополнительных узлов или контрольных переменных. Эффекты медиа меняются по регионам, но не во времени.¹⁰
Robyn моделирует один временной ряд. Проверка входных данных останавливается с ошибкой на повторяющихся датах с пометкой panel data, поэтому региональный анализ - это либо одна национальная модель, либо по модели на регион без pooling между ними.⁶ Baseline даёт Prophet: Robyn обучает Prophet на KPI и подаёт компоненты тренда, сезонности и праздников (плюс день недели для дневных данных) в ridge-регрессию как регрессоры. Коэффициенты медиа постоянны на всём окне моделирования. Риск, за которым я слежу: тренд Prophet подгоняется под сам KPI, и тренд, совпавший с наращиванием расходов, может забрать часть эффекта медиа.
PyMC-Marketing принимает любые измерения, например dims=("geo",). Pooling - ваше решение через priors: по умолчанию у каждого региона свои параметры без иерархии, и для частичного pooling иерархические priors нужно прописать самому. Сезонность задаётся членами Фурье; меняющийся во времени intercept и меняющиеся во времени эффекты медиа доступны через приближённый гауссовский процесс в гильбертовом пространстве (HSGP), по умолчанию с одним общим множителем медиа для всех каналов.¹² Это единственный из трёх фреймворков, который из коробки позволяет эффективности медиа меняться со временем.
Оптимизация бюджета, валидация и вычисления
Оптимизация бюджета
- Meridian: фиксированный бюджет с максимизацией ROI (по умолчанию каждый канал в пределах ±30% от исторических расходов) или гибкий бюджет до целевого общего ROI либо до целевого маржинального ROI по каналу (границы каналов 0-200%).¹⁹ Scenario Planner, в открытой бете с февраля 2026, показывает эти сценарии в интерфейсе без кода.²⁰
- Robyn: robyn_allocator с двумя сценариями, максимальный отклик при фиксированном бюджете или целевая эффективность (по умолчанию 80% от исходного ROAS или 120% от исходного CPA), решается через nloptr; ограничения каналов задаются кратными от средних исторических расходов.⁹
- PyMC-Marketing: оптимизатор бюджета на SLSQP из SciPy, который работает с сэмплами posterior и поддерживает целевые функции с учётом риска, такие как value at risk, conditional value at risk и коэффициент Шарпа.¹²
Что бы вы ни использовали, плейбук Google рекомендует сдвигать не больше 20% расходов канала за раз.¹⁸ Оптимизатор экстраполирует кривую; рынок не обязан ей следовать.
Валидация
- Meridian: holdout по неделям или регионам (декларативные спецификации holdout с 2.1.0), R², MAPE и взвешенный MAPE на обучении и тесте, и health checks: сходимость (R-hat ниже 1,2 - пройдено), вероятность отрицательного baseline, байесовское posterior predictive p-value и насколько posterior ROI сдвинулся от prior.²¹
- Robyn: разбиение по времени на обучение, валидацию и тест, причём доля обучения сама является гиперпараметром (по умолчанию от 0,5 до 0,8), и графики, показывающие, сошлись ли целевые функции.⁹
- PyMC-Marketing: скользящая кросс-валидация по временным срезам, posterior predictive checks и прогнозы вне выборки с credible intervals.¹²
Вычисления
- Meridian рекомендует минимум один GPU и тестировался на T4 с 16 ГБ; JAX - бэкенд по умолчанию с 2.0.0. GPU - рекомендация, а не обязательное требование.²²
- Robyn работает на CPU и параллелится: по умолчанию использует все ядра, кроме одного, на минимум 2 000 итераций по 5 trials, и рядом с R ему нужен Python с Nevergrad.⁶
- PyMC-Marketing по умолчанию работает на CPU; NUTS можно переключить на BlackJax, NumPyro (оба на JAX) или Nutpie, а бэкенды PyMC позволяют ускорение на GPU.¹²
По объёму данных заявленные минимумы близки. Гайд Robyn требует минимум два года недельных данных и около 10 наблюдений на переменную.¹⁶ Meridian требует два года недельных данных для гео-модели и предлагает три для национальной, показывая, что 26 параметров на 104 недельных точках слишком мало для надёжной оценки.²³ В документации PyMC-Marketing фиксированного минимума я не нашёл; арифметика та же.
Полная сравнительная таблица
| Meridian | Robyn | PyMC-Marketing | |
|---|---|---|---|
| Разработчик | Meta Marketing Science | PyMC Labs | |
| Версия на октябрь 2026 | 2.1.0 (17.09.2026) | 3.12.1 на CRAN (02.07.2025) | 1.2.0 (29.09.2026) |
| Лицензия | Apache-2.0 | MIT | Apache-2.0 |
| Язык | Python 3.11-3.13 | R плюс Python для Nevergrad; robynpy в статусе beta | Python 3.12 и новее |
| Оценка | Байесовская, NUTS; бэкенд JAX по умолчанию | Ridge-регрессия (glmnet) внутри многокритериального поиска Nevergrad | Байесовская, NUTS; сэмплеры PyMC, BlackJax, NumPyro или Nutpie |
| Выбор модели | Одна модель плюс health checks | Фронт Парето по NRMSE и DECOMP.RSSD с кластеризацией; выбираете вы | Одна модель; варианты сравниваете вы |
| Неопределённость | Posterior, 90%-ные credible intervals по умолчанию | Bootstrap-интервал 95% для ROAS внутри кластера | Posterior, credible intervals |
| Priors | На ROI по умолчанию, LogNormal(0,2; 0,9) | Неявные: границы, ridge-штраф, DECOMP.RSSD | На коэффициенты по умолчанию, все заменяемы |
| Adstock | Геометрический, биномиальный; нормированный; max_lag 8 | Геометрический, Weibull CDF, Weibull PDF | Геометрический, delayed, Weibull, биномиальный, свой |
| Насыщение | Hill, наклон 1 для обычных каналов; reach and frequency | Hill (alpha, gamma) | Logistic, Hill, Michaelis-Menten, tanh и другие |
| Калибровка экспериментами | Эксперименты задают priors на ROI; CalibrationBuilder читает GeoX | Целевая функция MAPE.LIFT, только точечные оценки | Lift-тесты как правдоподобие Gamma; CPA или ROAS как нормальное правдоподобие |
| Регионы | Иерархия по умолчанию | Один временной ряд на модель | Любые измерения; pooling задают ваши priors |
| Baseline | Узлы (knots) | Тренд, сезонность и праздники Prophet | Сезонность Фурье, события, опционально GP-intercept |
| Эффекты медиа, меняющиеся во времени | Нет | Нет | Да, HSGP |
| Оптимизатор бюджета | Фиксированный бюджет, целевой ROI, целевой mROI; Scenario Planner | Максимальный отклик или целевая эффективность (nloptr) | SLSQP с целевыми функциями с учётом риска |
| Валидация | Спецификации holdout, R², MAPE, wMAPE, health checks | Разбиение по времени на обучение, валидацию и тест | Кросс-валидация по временным срезам, posterior predictive checks |
| Вычисления | Рекомендуется минимум 1 GPU | CPU, многоядерно | CPU по умолчанию; сэмплеры на JAX, возможен GPU |
| Заявленный минимум данных | 2 года недельных для гео, 3 года для национальной | 2 года недельных, 10 наблюдений на переменную | В просмотренной документации не указан |
| Порог входа (моё суждение) | Средний: Python и основы байесовской статистики | Низкий для R-пользователей; сложно читать набор моделей Парето | Высокий: модель проектируете вы |
| Время до первой модели (моё суждение) | Среднее | Самое быстрое для национальной модели | Самое долгое |
| Кому подходит (моё суждение) | Python-командам с данными по регионам и программой экспериментов | R-командам, которым быстро нужна национальная модель | Командам с байесовскими навыками, которым нужна своя структура |
Последние три строки - суждение по моим проектам, а не документация. Все остальные ячейки взяты из источников выше.
Инструменты рядом с MMM
| Инструмент | Что это | Состояние на октябрь 2026 | Для чего |
|---|---|---|---|
| Meridian GeoX¹⁵ | Дизайн и анализ гео-экспериментов от Google, Python, Apache-2.0 | 1.0.0 от 01.09.2026; открытый код считает только TBR | Эксперименты, которые становятся priors на ROI в Meridian |
| GeoLift²⁴ | Пакет Meta для гео-экспериментов на R, augmented synthetic control | GPL (≥ 2); нет на CRAN; последний релиз v2.6.06 (май 2023), версия 2.7.5 в main | Гео-тесты; рекомендует больше 20 гео-единиц и 25+ периодов до теста; iROAS не выдаёт, его считают из прироста и расходов |
| CausalImpact²⁵ | R-пакет Google, байесовские структурные временные ряды | 1.4.1 (26.09.2025)²⁶ | Эффект одного вмешательства на одном ряду; не модель медиа-микса |
| Orbit²⁷ | Python-библиотека прогнозирования от Uber с бэкендами Stan и Pyro и ядерной регрессией с меняющимися во времени коэффициентами | 1.1.5.1 (22.05.2026) | Регрессия с меняющимися коэффициентами, вокруг которой вы строите MMM сами |
| Recast²⁸ | Коммерческий управляемый MMM | Байесовская иерархическая модель временных рядов, оцениваемая в Stan; параметры, включая ROI, меняются во времени через гауссовский процесс | Покупка управляемого сервиса |
Именно эксперименты превращают любой из трёх фреймворков из упражнения по подгонке в систему измерений; дизайн экспериментов разобран в гайде по GeoX и GeoLift.
Таблица выбора
| Ситуация | Что выбрать |
|---|---|
| Нет аналитика внутри, который может владеть моделью | Управляемый сервис или сертифицированный партнёр |
| Команда только на R, национальная модель нужна за недели | Robyn с зафиксированной версией и калибровкой |
| Команда только на R, время есть | Перенести работу в Python и выбирать ниже |
| Python-команда, бюджеты и KPI по регионам | Региональная модель Meridian, эксперименты как priors на ROI |
| Python-команда, региональные данные плюс свой pooling, меняющиеся эффекты или lift-тесты как данные | PyMC-Marketing |
| Python-команда, только национальные данные, сильный байесовский опыт | PyMC-Marketing |
| Python-команда, только национальные данные, базовый байесовский опыт | Национальная модель Meridian на трёх годах недельных данных |
Вопросы стоят в том порядке, в каком я их задаю. Владелец и язык идут первыми: технически более сильный инструмент, который некому поддерживать, проигрывает более простому, который кто-то в команде потянет.
Команда, бюджет и данные в Казахстане и СНГ
Навыки
Большинство аналитических команд, с которыми я работаю в регионе, пишут на Python и SQL; R - исключение. Robyn нужны обе среды, R для самого пакета и Python для Nevergrad через reticulate, а это удваивает окружение, которое нужно поддерживать. Meridian требует Python 3.11-3.13, PyMC-Marketing - 3.12 и новее, так что проверьте корпоративный образ Python до планирования проекта. Главный разрыв в навыках - байесовский: настройки Meridian по умолчанию позволяют аккуратному аналитику получить разумную первую модель, а PyMC-Marketing предполагает человека, который умеет задать prior, прочитать trace plot и объяснить, почему цепь не сошлась.
GPU и информационная безопасность
Meridian рекомендует GPU. Облачные рабочие среды с GPU есть у крупных облачных провайдеров; в банках обычно мешает не цена, а согласование с информационной безопасностью. Входные данные MMM - агрегированные недельные расходы и результаты по регионам без персональных данных, и это облегчает согласование, но уровни расходов - коммерческая тайна, поэтому начинайте согласование до старта проекта, а не на третьей неделе. Если облако исключено, национальная модель Meridian работает на CPU, медленнее; PyMC-Marketing и Robyn и так инструменты для CPU.
Около 20 регионов, два из которых доминируют
В Казахстане 17 областей и 3 города республиканского значения, около 20 гео-единиц против 210 медиарынков в США. Рекомендации Meridian для США рассчитаны на 50-100 крупнейших рынков и советуют сначала убирать самые маленькие по KPI регионы;²³ GeoLift рекомендует больше 20 гео-единиц для экспериментов.²⁴ Двадцать единиц всё равно дают гео-модели намного больше точек, чем национальной, но Алматы и Астана доминируют в итогах, а значительная часть медиа закупается на всю страну. Что я делаю:
- Проверяю, какая доля расходов каждого канала действительно таргетирована по регионам. Национальная закупка ТВ или digital-кампания без гео-таргетинга в Meridian распределяется по регионам пропорционально населению: строк становится больше, информации - нет.
- Объединяю самые маленькие области, чей недельный KPI в основном шум, и документирую объединение.
- Если доля гео-таргетированных расходов мала, строю национальную модель на трёх годах недельных данных, а силы вкладываю в эксперименты.
- В PyMC-Marketing явно прописываю иерархические priors; настройки по умолчанию оставляют каждый маленький регион сам по себе.
Офлайн-конверсии
У банков, страховщиков и суперприложений KPI часто закрывается офлайн: визит в отделение, продажа в колл-центре, кредит, выданный через дни или недели после заявки. Для выбора инструмента из этого три следствия:
- KPI должен быть количеством или суммой, которые складываются по регионам и неделям, Meridian требует этого явно. Моделируйте выдачи или заявки, но не конверсию в процентах.
- Привязывайте каждую конверсию к региону по одному фиксированному правилу, регион отделения или регион проживания клиента, и не меняйте его на всей истории. Как вообще собрать такие конверсии, разобрано в статье про офлайн-атрибуцию отделений банка.
- Если эффект достигает пика через несколько недель после рекламы, нужен adstock с отложенным пиком: Weibull PDF в Robyn или delayed adstock в PyMC-Marketing. Геометрическая и биномиальная формы в Meridian обе имеют пик в неделю расходов, биномиальная лишь удлиняет хвост. Альтернатива - моделировать более ранний KPI, например заявки, и пересчитывать его.
Управляемые сервисы
Цены я называть не буду: они зависят от объёма работ и часто меняются. Сравнивать нужно стоимость вендора с внутренней стоимостью аналитика, который строит и обновляет модель, плюс программу экспериментов, которая держит её в честности. Вендор снимает с вас моделирование, но не конвейер данных и не эксперименты. Перед подписанием я прошу у любого вендора:
- Описание модели письменно: метод оценки, priors, формы adstock и насыщения.
- Как входят эксперименты: как priors, как слагаемые правдоподобия или как проверка постфактум.
- Какой тест вне выборки они показывают и на каком holdout.
- Определение ROI: период, контрфактический сценарий, окно переноса, выручка или конверсии.
- Право выгрузить недельную таблицу входных данных и все результаты модели, если вы уйдёте.
У Google есть список сертифицированных партнёров Meridian (больше 20 на запуске в январе 2025),¹ а Recast публикует техническую документацию своей модели,²⁸ и это тот уровень прозрачности, которого я бы ждал от любого вендора.
Типичные ошибки
Выбор по популярности
Звёзды на GitHub и доклады на конференциях измеряют известность инструмента, а не то, насколько он подходит вашим данным. Robyn широко известен и заморожен; такое сочетание - риск, а не рекомендация. Решают другие вопросы: на каком языке пишет команда, есть ли данные по регионам и как вы будете использовать эксперименты.
Доверие одной модели с фронта Парето
Robyn намеренно возвращает набор почти равноценных моделей. Смотрите на разброс ROAS каждого канала по кластерам: если он идёт от убыточного до отличного, данные не могут дать ответ, и этому каналу нужен эксперимент. Байесовская версия той же ошибки - показывать среднее posterior без интервала.
Сравнение ROI между инструментами с разными определениями
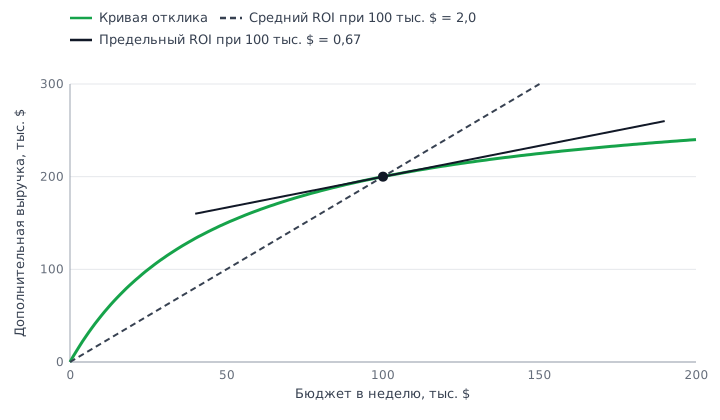
ROAS в Robyn - это вклад из декомпозиции, делённый на расходы, на ненормированном adstock. ROI в Meridian - инкрементальный результат относительно нулевых расходов в пределах окна max_lag, сводка по posterior. Маржинальный ROI в Meridian - отдача от расходов, увеличенных на 1%; маржинальный ROAS в Robyn снимается с кривой отклика на заданном уровне расходов. Прежде чем ставить две цифры рядом, выровняйте период, KPI, контрфактический сценарий, окно переноса и то, средний это показатель или маржинальный.
Одна только разница между средним и маржинальным может быть трёхкратной. На кривой отклика с максимумом 300 тыс. $ и полунасыщением при 50 тыс. $ недельных расходов выручка при 100 тыс. $ равна 300 × 100 / (100 + 50) = 200 тыс. $, то есть средний ROI 200 / 100 = 2,0, а маржинальный ROI, наклон 300 × 50 / (100 + 50)², около 0,67.
Дрейф версий
Robyn поменял точку перегиба Hill в v3.12.0, поэтому то же gamma означает другую кривую, чем в 3.11.x, а robynpy переведён с 3.11.1. Meridian 2.0.0 переключил бэкенд по умолчанию на JAX, калиброванные priors на ROI на JAX могут не совпадать с TensorFlow, пока не выйдет исправление, а 2.1.0 объявил устаревшими аргументы-массивы вроде roi_calibration_period. PyMC-Marketing 1.0.0 сделал многомерную модель классом по умолчанию. Фиксируйте версии и храните точную версию рядом с каждым результатом модели.
Один эксперимент не калибрует канал
Тест измеряет один период, один уровень расходов и один набор регионов. Плейбук Google называет калибровку целого канала по одному эксперименту ошибкой. Планируйте серию, а в PyMC-Marketing или Meridian позвольте собственной неопределённости эксперимента определять, насколько сильно он тянет модель.
Следующий шаг
Практический следующий шаг одинаков для любого варианта: соберите недельную таблицу расходов, показов, KPI и контрольных переменных по регионам, потому что она питает все три инструмента и её качество решает больше, чем выбор фреймворка.
Источники
¹ Meridian is now available to everyone - Google blog, January 2025
² Meridian CHANGELOG - Google, GitHub
³ PyMC-Marketing 1.0.0 release notes - PyMC Labs, GitHub
⁴ pymc-marketing release history - PyPI
⁵ Robyn: Semi-Automated Marketing Mix Modeling - CRAN
⁶ Robyn repository and source code - Meta Marketing Science, GitHub
⁷ robynpy - PyPI
⁸ LightweightMMM repository (archived) - Google, GitHub
⁹ Robyn features and methodology - Meta
¹⁰ Meridian model specification - Google for Developers
¹¹ Calibrate treatment priors with experiments - Meridian, Google for Developers
¹² PyMC-Marketing repository and README - PyMC Labs, GitHub
¹³ Chan, Perry (2017) Challenges and Opportunities in Media Mix Modeling - Google Research
¹⁴ Set the adstock_decay_spec parameter - Meridian, Google for Developers
¹⁵ Meridian GeoX - Google for Developers
¹⁶ An analyst's guide to MMM - Robyn docs, Meta
¹⁷ Lift test calibration - PyMC-Marketing docs
¹⁸ Modern Measurement playbook, March 2024 - Google
¹⁹ Budget optimization scenarios - Meridian, Google for Developers
²⁰ New Meridian tool puts MMM insights directly in marketers' hands - Google blog, February 2026
²¹ Model health checks - Meridian, Google for Developers
²² Meridian repository and README - Google, GitHub
²³ Amount of data needed - Meridian, Google for Developers
²⁴ GeoLift repository - Meta, GitHub
²⁵ Brodersen et al. (2015) Inferring causal impact using Bayesian structural time-series models - Annals of Applied Statistics
²⁶ CausalImpact - CRAN
²⁷ Orbit repository - Uber, GitHub
²⁸ Recast model technical documentation - Recast
Частые вопросы
Можно ли запустить Robyn и Meridian параллельно и усреднить результаты?
Запуск двух инструментов на одних данных - полезная проверка устойчивости, но усреднение их ROI смешивает разные определения: ненормированный и нормированный adstock, ridge-декомпозицию, подтянутую к долям расходов, и posterior, подтянутый к вашим priors. Используйте расхождение по-другому. Каналы, где инструменты расходятся сильнее всего, - первые кандидаты на эксперимент.
Не завышает ли Meridian каналы Google, раз его сделал Google?
Код открыт под лицензией Apache-2.0, а prior на ROI по умолчанию одинаков для всех платных каналов, LogNormal(0,2; 0,9), так что в самой спецификации нет преимущества для Google. Смещение может прийти из входных данных: канал с более богатыми данными, например с reach and frequency или чистой разбивкой по регионам, получает более точную оценку, чем канал с одной национальной строкой расходов. Проверьте качество данных по каждому каналу, прежде чем читать рейтинг.
Нужен ли GPU для PyMC-Marketing или Robyn?
Нет. Robyn работает на CPU и распределяет поиск по ядрам. PyMC-Marketing по умолчанию работает на CPU и может переключиться на сэмплеры на JAX, например NumPyro или BlackJax, которые используют GPU, если он есть. GPU рекомендует только Meridian, и даже он работает на CPU, просто медленнее.
Если начать с одного фреймворка, можно ли потом перейти на другой без потери работы?
Основная работа - это недельная таблица входных данных (расходы, показы, KPI и контрольные переменные по регионам) и журнал экспериментов (даты, расходы, прирост и его стандартная ошибка), и оба переносятся в любой инструмент. Оценённые параметры и границы гиперпараметров не переносятся: нормировка adstock, определение Hill и параметризация priors различаются, поэтому модель придётся переоценить и заново проверить. Держите слой данных независимым от инструмента с первого дня.
Допустимо ли использовать Robyn в банке в 2026 году?
Технически да: версия 3.12.1 есть на CRAN, код под лицензией MIT. Риск в поддержке: в основную ветку никто не коммитит с июня 2025 года, так что ошибки и поломки зависимостей придётся чинить вам. Если используете его, зафиксируйте всё окружение R и Python в контейнере, записывайте версию рядом с каждым результатом и планируйте переход на поддерживаемый фреймворк.
Узнаёте свою воронку?
Две недели, фиксированный скоуп, доступы только на чтение. Находки и роадмап на 90 дней остаются у вас в любом случае.