Гео-эксперимент отвечает на вопрос, который атрибуция и MMM сами закрыть не могут: случились бы эти продажи без канала? В части регионов вы меняете бюджет, остальные не трогаете и сравниваете тестовые регионы с прогнозом, построенным по нетронутым. Метод работает для продаж в отделениях, ТВ, наружной рекламы и любой рекламной платформы, потому что ему нужны только расходы и ваш собственный KPI по регионам и неделям. Сложность в мощности: при примерно 20 пригодных регионах в Казахстане и приросте в несколько процентов тест без анализа мощности заканчивается выводом «незначимо» и сжигает бюджет.
Это третья статья из серии из четырёх. Обзор MMM объясняет, что оценивает модель, Google Meridian на практике показывает, как её построить, а Meridian, Robyn и PyMC-Marketing сравнивает библиотеки. Здесь речь об экспериментах, которые держат эти модели в рамках реальности.
Зачем эксперименты: корреляция не равна инкрементальности
MMM - это регрессия на исторических данных. В плейбуке Google по измерениям это сказано прямо: MMM опирается на корреляции, поэтому её точность зависит от масштаба, времени и вариативности прошлых расходов, и хуже всего она работает с небольшими каналами, каналами always-on и поиском, который собирает уже существующий спрос.¹ Если бюджет брендового поиска растёт каждый раз, когда растёт спрос, модель не отличит причину от следствия. У атрибуции обратная слепая зона: она считает, кто кликнул перед конверсией, а не кто купил бы и так.
Эксперимент ломает корреляцию: вы намеренно меняете расходы в выбранной части рынка, а остальной рынок служит сравнением. В гео-эксперименте единицы - это регионы: непересекающиеся территории, на которые рекламные платформы умеют таргетироваться по отдельности и в которых KPI можно посчитать отдельно.² Тесту нужны только агрегаты (расходы и KPI по региону за день или неделю), пользовательские данные не используются, поэтому Google называет гео-эксперименты способом измерения, бережным к приватности.³
Что измеряет гео-тест
Каждое число гео-теста - это сравнение с контрфактическим сценарием (counterfactual): что сделали бы тестовые регионы без изменения. Напрямую его никто не наблюдает, поэтому вся работа метода в том, чтобы спрогнозировать его по регионам, которые не трогали.
Здесь - фактический KPI тестовой группы в неделю t, - контрфактический прогноз на ту же неделю, Δ - инкрементальный KPI, просуммированный по неделям теста. В GeoX это называется средним эффектом воздействия на подвергшихся воздействию (ATT) на уровне регионов; с точки зрения пользователя это эффект намерения воздействовать (intention-to-treat), потому что рекламу видит не каждый житель тестового региона.³
- дополнительные расходы, поэтому iROAS (incremental return on ad spend) - это дополнительная выручка на каждый дополнительный доллар, а прирост (lift) - инкрементальный KPI как доля контрфактического. Если KPI не выручка (заявки, выданные полисы), то же отношение превращается в число дополнительных конверсий на доллар или, наоборот, в стоимость дополнительной конверсии. GeoX выдаёт его как iCPD, incremental conversions per dollar, и при KPI-выручке iCPD равен iROAS.⁴
Когда пользовательских lift-тестов недостаточно
Conversion lift-исследования платформ рандомизируют пользователей и в своих границах чище и дешевле гео-теста. Проблема как раз в границах:
| Пользовательский conversion lift | Гео-эксперимент | |
|---|---|---|
| Что рандомизируется | Пользователи или cookies внутри одной платформы | Регионы |
| KPI | Конверсии, которые видит платформа | Ваш KPI из бэкенда, онлайн и офлайн |
| Каналы | Одна платформа за раз | Любой канал, который покупается по регионам: поиск, соцсети, видео, наружная реклама, региональное ТВ |
| Сравнимость между платформами | Нет: каждая платформа тестирует свою аудиторию со своим определением конверсии | Да: один KPI, один метод |
| Нужный масштаб | Подходит и для небольших кампаний | Нужен объём: достаточно регионов, расходов и KPI |
Плейбук Google делит так же: пользовательский lift страдает от пробелов в трекинге (ITP, встроенные браузеры приложений), а open-source гео-эксперименты отражают все реализованные конверсии, но ресурсоёмки и шумнее, поэтому подходят для крупных каналов.¹ В документации GeoLift Meta отмечает, что её собственные lift-исследования зависят от доступа к онлайн-сигналам: пикселям, API и SDK.⁵ Для банка, страховой или ритейлера, у которых продажа закрывается в отделении, колл-центре или бэк-офисе, конверсия, которую платформа не видит, и есть весь вопрос. Если это ваш случай, статья про атрибуцию офлайн-продаж в отделениях показывает, как вообще довести эти конверсии до данных.
Три дизайна: holdback, go-dark, heavy-up
Meridian GeoX, open-source фреймворк Google для гео-экспериментов, выделяет три типа воздействия.⁶ Они отвечают на разные бюджетные вопросы и по-разному попадают в MMM, поэтому дизайн выбирают по вопросу, а не по привычке.
- Новые расходы против нуля. Holdback. Тестовые регионы получают новый канал, кампанию или формат, контрольные не получают ничего. Подходит, чтобы проверить новый канал до масштабирования. Измеряет среднюю отдачу всех расходов относительно нуля.
- Действующие расходы выключены. Go-dark. В тестовых регионах расходы отключают, в контрольных всё идёт в обычном режиме. Подходит, чтобы доказать ценность работающего канала: сколько продаж вы потеряете без него. Измеренный эффект отрицательный, и анализ меняет его знак. Тоже измеряется относительно нуля.
- Дополнительные расходы сверху. Heavy-up. Тестовые регионы получают обычный бюджет плюс X%, контрольные остаются на обычном. Подходит, чтобы оценить следующий шаг бюджета или когда текущих расходов мало для мощного go-dark. Измеряет предельную отдачу, а не среднюю.
GeoX также различает одноячеечные тесты (одна тестовая группа против одной контрольной) и многоячеечные (несколько тестовых групп с общей контрольной). Документация называет одноячеечный вариант более надёжным, потому что вся статистическая мощность уходит в одно сравнение, а многоячеечному нужно существенно больше регионов и бюджета, и минимальный обнаружимый эффект у него выше.⁶ При примерно 20 регионах я бы многоячеечный тест не запускал.
Сначала вопрос. Holdback и go-dark отвечают на вопрос «окупает ли канал весь свой бюджет», то есть про среднюю отдачу. Heavy-up отвечает на вопрос «стоит ли вкладывать сюда следующий доллар», то есть про предельную. На насыщающейся кривой отклика они могут сильно различаться и, как будет видно ниже, попадают в MMM через разные двери.
Рандомизация, стратификация, пары или подобранные рынки
Когда воздействие выбрано, решите, какие регионы его получат.
- Полная рандомизация. Монетка для каждого региона защищает от известных и неизвестных различий, но только если регионов много. При малом числе регионов монетка легко сложит все крупные города в одну группу.⁷
- Стратифицированная рандомизация. Сначала сгруппировать похожие регионы, потом рандомизировать внутри групп. Vaver и Koehler показали, что группировка регионов по размеру перед распределением может сузить доверительный интервал ROAS на 10% и больше.² GeoX делает это по умолчанию: описывает ряд KPI каждого региона средним, коэффициентом вариации, наклоном тренда, автокорреляцией с лагом 1 и расстоянием dynamic time warping, разбивает регионы на четыре страты методом k-means и рандомизирует внутри страт.³ Кандидат-дизайн проходит дальше, только если контрфактический прогноз хорошо работает вне обучающей выборки (по умолчанию R² не ниже 0,8) и A/A-тест на отложенной части предтестового периода не показывает смещения; прошедшие ранжируются по минимальному обнаружимому эффекту.⁴
- Парная рандомизация. Отсортировать регионы по размеру, объединить соседей в пары и бросить монетку внутри каждой пары. Под такой дизайн построен Trimmed Match,⁸ и такую же разбивку на пары Kerman и соавторы используют в анализе мощности для TBR.⁷
- Подобранные рынки (matched markets). Вручную выбрать один или несколько тестовых рынков и сопоставимые контрольные. Дёшево и практично, но Kerman и соавторы прямо пишут, что такой дизайн не даёт защиты рандомизации от скрытых смещений.⁷ Выбор рынков в GeoLift - вариант того же подхода на основе мощности: он ранжирует наборы тестовых рынков по смоделированной мощности и показывает минимальный обнаружимый эффект для каждого.⁵
Моё правило: рандомизировать, стратифицированно или парами, всегда, когда позволяет число регионов, и переходить к подобранным рынкам с синтетическим контролем только при очень малом числе регионов или когда один-два из них нельзя отправить в тест случайно.
Как читать гео-тест регрессией по времени
Регрессия по времени (time-based regression, TBR), опубликованная Kerman, Wang и Vaver в 2017 году, - основной инструмент гео-тестов Google и главный метод GeoX.⁷ ³ Сначала KPI суммируется (или усредняется) по регионам в один ряд на группу за день или неделю. На предтестовом периоде ряд тестовой группы регрессируется на ряд контрольной:
и - KPI тестовой и контрольной групп в неделю t, a учитывает разницу уровней между группами, b - то, как тестовая группа движется вслед за контрольной, - остаток. GeoX может ограничить b неотрицательными значениями и не делает предположений о распределении остатка, опираясь вместо этого на плацебо-инференс.³ В тестовом периоде подобранная прямая превращает фактические данные контрольной группы в контрфактический прогноз для тестовой:
- эффект в тестовую неделю t, Δ(t) - накопленный эффект к неделе t, iROAS(t) - накопленный дополнительный отклик, делённый на накопленные дополнительные расходы. Kerman и соавторы советуют следить за накопленной кривой: если она продолжает расти после окончания изменения расходов, эффект запаздывает и анализу нужен период последействия (cool-down); если выходит на плато, не нужен.⁷ TBR работает даже с одним тестовым и одним контрольным регионом, поэтому подходит и для тестов на подобранных рынках.⁷
Сквозной пример: четыре недели heavy-up
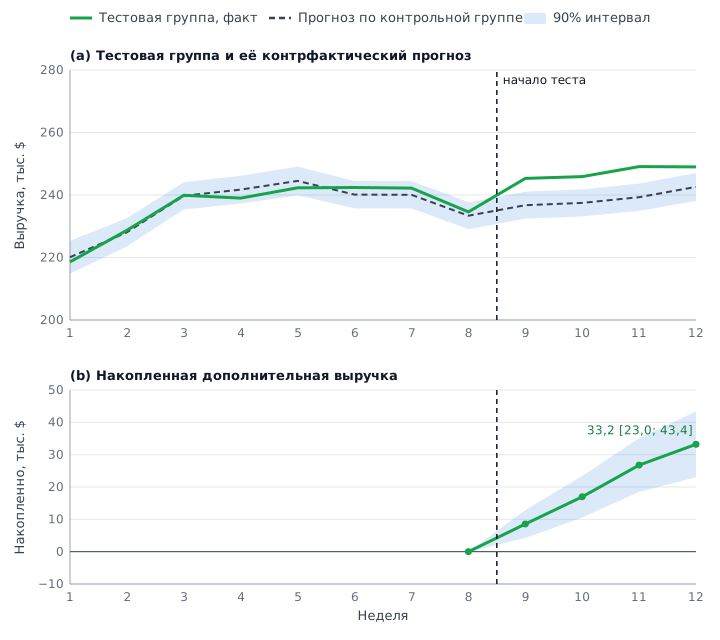
Числа ниже синтетические, они взяты из генератора, по которому построены все графики серии. Двенадцать недель выручки контрольной и тестовой групп: восемь предтестовых недель, затем четыре недели теста, за которые тестовая группа получила heavy-up на 20 тыс. $ дополнительных расходов в сумме. Метод наименьших квадратов на восьми предтестовых неделях даёт a = 39,69 и b = 0,4561, поэтому прогноз на неделю 9 равен 39,69 + 0,4561 × 432,0 = 236,7.
| Неделя | Период | Контроль, тыс. $ | Тест, тыс. $ | Прогноз a + b × контроль, тыс. $ | Эффект φ, тыс. $ |
|---|---|---|---|---|---|
| 1 | До теста | 395,5 | 218,6 | - | - |
| 2 | До теста | 413,0 | 228,7 | - | - |
| 3 | До теста | 438,6 | 239,9 | - | - |
| 4 | До теста | 442,9 | 239,0 | - | - |
| 5 | До теста | 449,0 | 242,3 | - | - |
| 6 | До теста | 439,4 | 242,4 | - | - |
| 7 | До теста | 439,3 | 242,2 | - | - |
| 8 | До теста | 424,6 | 234,6 | - | - |
| 9 | Heavy-up | 432,0 | 245,3 | 236,7 | 8,6 |
| 10 | Heavy-up | 433,6 | 245,9 | 237,5 | 8,4 |
| 11 | Heavy-up | 437,6 | 249,1 | 239,3 | 9,8 |
| 12 | Heavy-up | 444,8 | 249,0 | 242,6 | 6,4 |
| Итого за тест | 989,3 | 956,1 | 33,2 |
Итог:
- Инкрементальная выручка Δ = 8,6 + 8,4 + 9,8 + 6,4 = 33,2 тыс. $.
- iROAS = 33,2 / 20 = 1,66: каждый дополнительный доллар принёс 1,66 $ выручки сверх того, что было бы и так.
- Прирост = 33,2 / 956,1 = 3,5% к контрфактическому прогнозу.
Теперь честная часть. Генератор заложил истинный эффект 9 + 11 + 10 + 8 = 38 тыс. $, так что точечная оценка промахивается на 4,8 тыс. $, примерно на 13% (4,8 / 38). Ничего не сломано: восьми недель просто мало, чтобы точно определить a и b. Истинные значения в генераторе a = 20 и b = 0,5; подбор дал 39,69 и 0,4561, две ошибки, которые частично гасят друг друга на предтестовом периоде и не гасят полностью в неделях теста. Поэтому гео-тест всегда сообщают с интервалом. Kerman и соавторы дают дисперсию накопленного эффекта после T недель теста:⁷
Суммы берутся по T неделям теста, σ - стандартное отклонение остатка. Первые три слагаемых - неопределённость подобранной прямой, она уменьшается с ростом предтестового периода; последнее - свежий шум тестовых недель, он растёт с T. Когда σ оценивается по n предтестовым неделям, интервал строится по t-распределению с n - 2 степенями свободы. Для двенадцати недель из таблицы стандартная ошибка Δ равна 5,24 тыс. $, , и 90-процентный интервал составляет 33,2 ± 10,2, то есть от 23,0 до 43,4 тыс. $. Если разделить на известные 20 тыс. $ дополнительных расходов, iROAS лежит между 1,15 и 2,17. Истинные 38 тыс. $ внутри интервала; одна точечная оценка скрыла бы, насколько широк честный ответ.
Достаточно ли такого ответа, зависит от решения. Если каналу для окупаемости по марже нужен iROAS выше 1,0, тест говорит «да». Если планка 2,0, тест ответить не может, и правильнее было бы вести его дольше или с большим бюджетом. И ещё: пример специально нарушает правила, чтобы график читался: восемь предтестовых недель на четыре недели теста - это 2x, ниже минимума 3x в GeoX и 4-5x в GeoLift, о которых ниже.
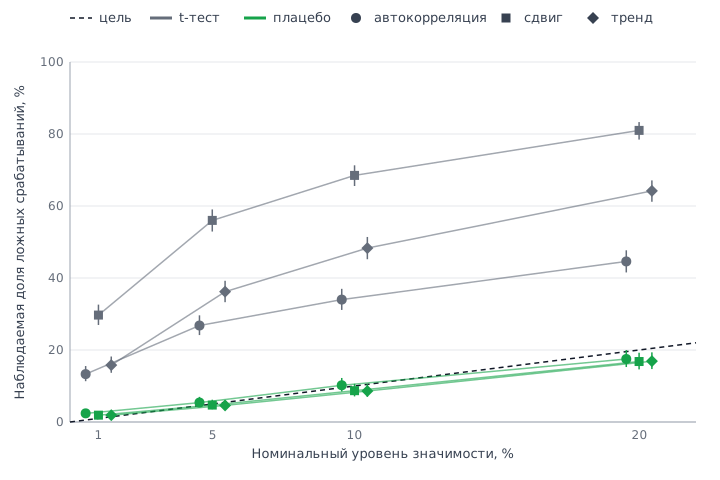
Интервалы в закрытой форме - для обучения. Интервал выше на основе t-распределения предполагает независимые остатки. Реальные дневные и недельные ряды KPI автокоррелированы и дрейфуют: в A/A-симуляциях на данных 192 рекламодателей авторы GeoX обнаружили, что обычный t-тест на номинальном уровне 5% даёт более чем в десять раз больше ложных срабатываний, чем ожидается. Поэтому GeoX использует плацебо-инференс с учётом дизайна, а GeoLift по умолчанию конформный инференс. Для бюджетного решения пользуйтесь инференсом библиотеки, а не t-тестом в таблице.
Другие методы: GBR, Trimmed Match, синтетический контроль и ASCM
Регрессия по регионам (GBR)
Метод Vaver и Koehler 2011 года - исходный подход Google.² Он сворачивает не регионы, а время: одна строка на регион, итоги за предтестовый и тестовый периоды.
и - итоги KPI региона g за предтестовый и тестовый периоды, - его дополнительные расходы (ноль в контрольных регионах), - iROAS, а регрессия взвешивается весами , чтобы учесть разный размер регионов. Мощность GBR берётся из числа регионов, именно поэтому Kerman и соавторы разработали TBR для рынков, где регионов мало.⁷ При примерно 20 регионах GBR не мой первый выбор.
Trimmed Match
Chen и Au (Annals of Applied Statistics, 2022) построили Trimmed Match для рандомизированных парных гео-экспериментов с небольшим числом сильно неоднородных регионов.⁸ Для каждой пары i берутся разности «тест минус контроль» по отклику, , и по расходам, , за тестовый период. Для кандидатного значения iROAS r остаток пары равен
а оценка - это такое r, при котором усечённое среднее этих остатков равно нулю, что сводится к
где - множество отброшенных пар с самыми крайними остатками. Одна плохо подобранная пара, например город с разовым событием, не может определить ответ, а уровень усечения выбирается по данным. Оценка не требует предположений о распределении; её реализует open-source библиотека Google trimmed_match. Ограничение для небольших рынков арифметическое: 20 регионов дают не больше 10 пар, и часть из них уходит на усечение.
Синтетический контроль и ASCM (GeoLift)
Синтетический контроль строит контрфактический прогноз как взвешенное среднее отдельных контрольных регионов, а не их простую сумму:³
Регион 1 - тестовый, C - множество контрольных регионов, веса подбираются так, чтобы взвешенный контроль повторял траекторию тестового региона в предтестовом периоде. Ограничение держит прогноз в пределах диапазона контрольных регионов: это безопасно, но не работает, когда никакая смесь контролей не повторяет предтестовый период достаточно хорошо, и авторы исходного метода в таком случае советуют синтетический контроль не применять.⁹ Аугментированный синтетический контроль (ASCM) Ben-Michael, Feller и Rothstein оценивает смещение от неидеальной подгонки с помощью модели исхода и вычитает его:⁹
- прогноз модели исхода (в основном варианте авторов это ридж-регрессия), так что первое слагаемое - обычный синтетический контроль, а скобка - оценка смещения из-за неидеальной подгонки на предтестовом периоде. Если подгонка уже хорошая, поправка мала; если нет, ASCM немного экстраполирует за пределы контрольных регионов, и ридж-штраф ограничивает, насколько далеко.⁹
GeoLift, open-source пакет Meta на R, использует ASCM, чтобы оценить синтетический контроль и убрать из него смещение.⁵ Он добавляет калькуляторы мощности и выбор рынков и выдаёт средний эффект воздействия (ATT), прирост в процентах, инкрементальный KPI, доверительный интервал и p-value. Встроенного iROAS нет: инкрементальную выручку нужно делить на тестовые расходы самостоятельно. На октябрь 2026 в ветке main на GitHub версия 2.7.5, последний тегированный релиз v2.6.06 от мая 2023 года, пакет ставится с GitHub, а не из CRAN.⁵
GeoX на октябрь 2026 - это Python-пакет meridian-geox (1.0.0 вышел 1 сентября 2026 года, лицензия Apache-2.0).⁴ Его white paper описывает TBR, синтетический контроль и синтетическую разность разностей и утверждает, что методы со взвешиванием регионов лучше работают, когда в пуле есть непропорционально крупные регионы или очень шумные ряды;³ в open-source коде сейчас работает только TBR.⁴ Статья Google также сравнивает GeoX с неназванной open-source библиотекой на ASCM и сообщает одинаковый медианный минимальный обнаружимый эффект (6%) при меньшем необходимом бюджете; это собственная оценка вендора, читайте её соответственно.³
Какой метод когда
| Ситуация | Метод | Инструмент |
|---|---|---|
| Десятки регионов и больше, рандомизированное или стратифицированное распределение | TBR (подходит и GBR) | GeoX |
| Рандомизированные пары, часть пар может оказаться плохо подобранной | Trimmed Match | trimmed_match |
| Мало регионов или один-два непропорционально крупных, которые нельзя рандомизировать | Синтетический контроль с ASCM, подобранные рынки | GeoLift |
| Один тестовый регион против одного контрольного | TBR работает на двух регионах, но без защиты рандомизации | GeoX, GeoLift |
| Только национальный канал, который нельзя разделить по регионам | Не гео-тест: анализ «до и после» с синтетическим контролем или широкий prior в MMM | CausalImpact, MMM |
Последняя строка взята из плейбука Google: он предлагает исследование Causal Impact, когда канал вроде ТВ или наружной рекламы нельзя купить по регионам, и отмечает, что всё равно нужен период с рекламой и период без неё.¹
Неопределённость: плацебо-вывод вместо t-теста
Чаще всего гео-тесты ломаются на интервале. t-тест, который сравнивает тестовые регионы с их собственной историей, предполагает независимые дни, но дневные продажи автокоррелированы, а шок, который бьёт по всем регионам сразу (праздник, смена цен, запуск конкурента), выглядит ровно как эффект воздействия. Статья Google про Meridian GeoX заменяет параметрический тест плацебо-выводом: сделать вид, что часть контрольных регионов получила воздействие, измерить найденный там эффект, повторить много раз и использовать это распределение как нулевое.³
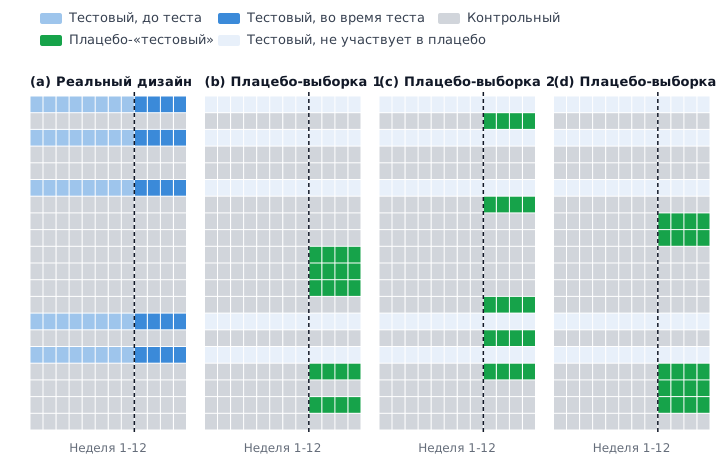
Симуляция ниже повторяет A/A-оценку из статьи на панели, похожей на Казахстан: 20 регионов, 56 дней до теста и 28 во время него, 5 регионов в тесте по жребию и никакого реального эффекта. В каждом сценарии 1 000 A/A-тестов. Корректный метод даёт ровную гистограмму p-value и признаёт значимыми около 5% тестов на уровне 5%.
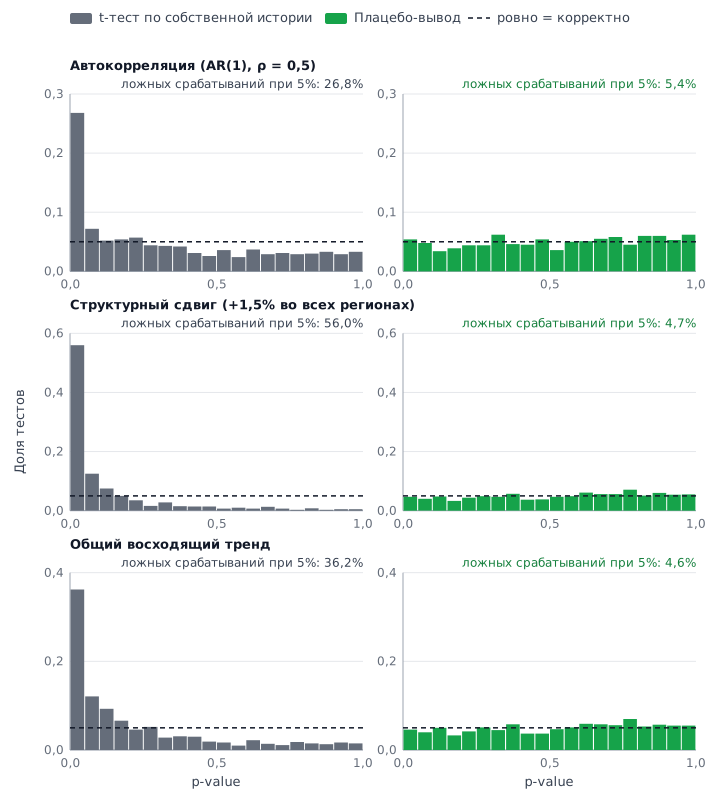
При автокоррелированном шуме (AR(1), ρ = 0,5) t-тест признаёт значимыми 26,8% тестов; при сдвиге на +1,5% во всех регионах через неделю после старта 56,0%; при общем восходящем тренде 36,2%. Плацебо-вывод держится на 5,4%, 4,7% и 4,6%, потому что сравнивает тестовые регионы с регионами, которые пережили тот же шок в то же время.
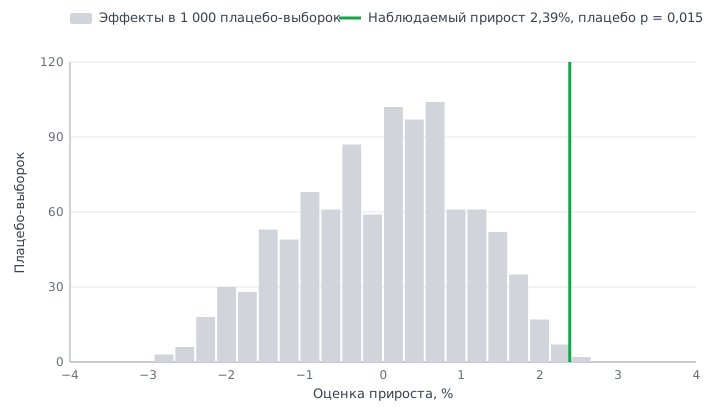
При реальном эффекте тот же механизм даёт p-value и интервал. В смоделированном тесте с истинным приростом 3% в пяти регионах оценка равна 2,39%. Только 14 из 1 000 плацебо-выборок дают эффект не меньше этого, поэтому p = 0,015; разброс плацебо-эффектов, 1,09 процентного пункта, даёт приближённый 90% интервал от 0,59% до 4,18%.
Мощность, минимальный обнаружимый эффект и длина теста
Гео-тест - ставка на то, что эффект достаточно велик, чтобы проявиться сквозь шум региональных продаж. Методология GeoLift говорит об этом прямо: без анализа мощности до теста высок шанс не найти прирост, который на самом деле был.⁵ Анализ мощности даёт минимальный обнаружимый эффект (MDE): наименьший эффект, который дизайн обнаружит с выбранными уровнем доверия и мощностью.
- 3x: предтестовый период к длине теста, минимум GeoX
- 4-5x: предтестовый период к длине теста, рекомендация GeoLift
- 25 и 20+: предтестовых периодов и гео-единиц, минимум GeoLift
- 7-14 недель: GeoX: от планирования до готового анализа
GeoX определяет MDE так:³
- стандартная ошибка инкрементального отклика, Baseline - отклик тестовой группы без воздействия, α - уровень значимости, π - целевая мощность; по умолчанию в GeoX двусторонний α = 0,1 (доверие 90%) и π = 0,8, что даёт z-значения 1,645 и 0,842.⁴ Для нового запуска бюджет, нужный для такого MDE, следует отсюда напрямую:³
Применим это к примеру. При стандартной ошибке 5,24 тыс. $ обнаружимый эффект равен , то есть 13,0 тыс. $, или 1,4% от базы 956,1 тыс. $. Heavy-up дал 33,2 тыс. $, с запасом выше. Теперь представим, что тот же тест добавил бы только 5 тыс. $ расходов: при том же iROAS 1,66 ожидаемый эффект около 8,3 тыс. $ (5 × 1,66), ниже MDE в 13,0 тыс. $, и тест почти наверняка показал бы «незначимо», какой бы ни была правда. По формуле бюджета при iROAS 1,66 (стоимость 1 / 1,66 = 0,60 на доллар дополнительной выручки) минимальные дополнительные расходы для этого дизайна около 13,0 × 0,60 = 7,8 тыс. $. В реальном дизайне стандартную ошибку оценивают до теста, по истории: Kerman и соавторы сдвигают окно длиной в планируемый тест по прошлым данным, считают интервал для каждого псевдоэксперимента и берут медиану,⁷ а GeoX и GeoLift делают аналогичные симуляции сами.
Для масштаба: в бенчмарке из статьи GeoX по 69 исследованиям рекламодателей медианный MDE выбранных дизайнов был 6%.³ Канал, от которого вы ждёте 2% прироста продаж, типичным дизайном не протестировать, как бы ни хотелось получить ответ.
Тест, который не может обнаружить ожидаемый эффект, - выброшенные деньги. Если анализ мощности показывает MDE выше эффекта, который вы реально ждёте, тест почти наверняка закончится «незначимо» независимо от правды. Вы заплатите за медиа, за продажи, потерянные в регионах go-dark, и за время аналитика и не узнаете ничего, чего не сказал бы prior. Меняйте дизайн (больше расходов, длиннее тест, больше регионов, менее шумный KPI) или не запускайте.
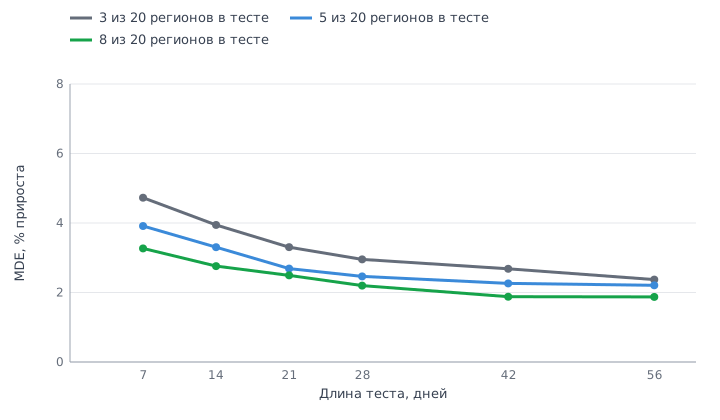
На той же смоделированной панели при 5 тестовых регионах из 20 минимальный обнаружимый прирост падает с 3,91% для недельного теста до 2,46% за четыре недели и 2,21% за восемь. За четыре недели 8 тестовых регионов вместо 3 снижают его с 2,95% до 2,20%, сильнее, чем удлинение теста на трёх регионах до восьми недель (2,37%). Эти значения зависят от шума в симуляции, 5% в день при ρ = 0,5; ваши дают тот же расчёт на вашей истории.
Что двигает MDE
Kerman и соавторы перечисляют рычаги в порядке силы:⁷
- Интенсивность расходов. Самый влиятельный параметр: удвоение изменения расходов в неделю вдвое сужает интервал iROAS. Обратная сторона: больше расходов - дальше в зону убывающей отдачи.
- Длина предтестового периода. Полуширина интервала падает примерно как квадратный корень из числа предтестовых точек, но не ниже определённого предела.
- Длина теста. Помогает, пока держится интенсивность расходов, с убывающим выигрышем.
- Регионы. Число регионов не входит в TBR напрямую, но при очень малом их числе подгонка хуже и контрфактический прогноз шумнее. Высокая корреляция рядов тестовой и контрольной групп улучшает подгонку.
Рекомендации по длительности из двух библиотек:
- GeoX: планирование до 2 недель, активный тест от 3 до 10 недель и последействие от 2 недель, если конверсии запаздывают, всего от 7 до 14 недель; предтестовых данных не меньше 3x длины теста с разбиением на обучение, валидацию и оценку, и больше, если KPI сезонный.¹⁰ ³
- GeoLift: дневные данные настоятельно предпочтительнее недельных; предтестовый период в 4-5 раз длиннее теста и без структурных сломов; не меньше 25 предтестовых периодов и 20 или больше гео-единиц; около 52 недель истории для учёта сезонности; тест не короче 15 дней на дневных данных или 4-6 недель на недельных и не короче одного цикла покупки.¹¹
Длинный цикл продаж требует отдельного внимания. Заявка на кредит, которая превращается в выдачу через три недели, или ипотека, закрывающаяся через два месяца, могут прийти уже после окончания теста. Плейбук Google предлагает в таких случаях мерить микроконверсию, которая предсказывает продажу (заявку, одобрение), и выбирать её корреляционным анализом.¹ Если идёте этим путём, проверьте, что деньги действительно следуют за микроконверсией; статья про лиды Google Ads без выдач показывает, насколько далеко они могут разойтись.
Казахстан и СНГ: двадцать регионов и два гиганта
В Казахстане 17 областей и 3 города республиканского значения (Алматы, Астана и Шымкент): около 20 гео-единиц. Статьи Google про гео-тесты исходят из 210 DMA Nielsen в США.⁷ Для большинства бизнесов Алматы и Астана дают непропорционально большую долю объёма. Это ставит казахстанский тест на минимум GeoLift в 20 гео-единиц или чуть ниже, далеко от комфорта рандомизации 210 регионов, и ровно в ситуацию, которую статья GeoX называет главным источником стоимости: непропорционально крупные регионы без сопоставимой пары, в их примерах Нью-Йорк и Лондон.³ Та же логика работает на любом рынке, где регионов первого уровня несколько десятков или меньше.
Что я бы с этим делал:
- Распределение. Зафиксировать роль гигантов. Не позволяйте случайному розыгрышу отправить Алматы или Астану в тестовую группу. Либо оставьте оба города вне эксперимента (обычный режим, исключены из анализа) и тестируйте на остальных регионах, либо, если крупный город нужно тестировать, используйте синтетический контроль в GeoLift со всеми остальными регионами в роли доноров. Простое суммирование регионов в TBR хуже всего справляется с непропорционально крупными регионами.
- Детализация. Дробить регионы, где позволяет KPI. Областной центр и остальная область или крупные города как отдельные единицы могут почти удвоить их число, но только если каждая платформа в тесте умеет таргетироваться на них отдельно, а бэкенд надёжно относит каждый заказ или заявку к единице. Kerman и соавторы собрали 29 гео-единиц для Франции из городов, доступных для таргетинга. Не уходите слишком мелко: Vaver и Koehler предупреждают, что единицы размером с почтовый индекс непригодны, потому что показ рекламы неточен, а люди пересекают границы.
- Дизайн. Стратифицировать или разбивать на пары. На 20 единицах чистая монетка - это лотерея. Используйте стратифицированное распределение (по умолчанию в GeoX) или пары по размеру с рандомизацией внутри пар и до запуска проверьте результат A/A на предтестовом периоде.
- Воздействие. Go-dark на небольших регионах. Отключение канала в группе небольших областей ограничивает выручку под риском, а go-dark измеряется относительно нулевых расходов, что и нужно для prior в MMM. Но снимаемые расходы всё равно должны быть велики относительно шума этих регионов: считайте мощность именно на них.
- Время. Дольше и с большим MDE. При малом числе единиц остаётся рычаг времени: длиннее предтестовый период, тест ближе к верхней границе диапазона GeoX в 10 недель, дневные данные, где KPI это позволяет. Заранее договоритесь, с каким MDE бизнес готов жить; если он выше правдоподобного эффекта, останавливайтесь.
- Запасной вариант. Признать, что канал не тестируется. Если ни один дизайн не опускает MDE ниже правдоподобного эффекта, используйте национальный период «включено-выключено» с анализом Causal Impact или оставьте prior канала в MMM широким и прямо напишите об этом в отчёте. Широкий prior честен, имитация эксперимента нет.
Требования к данным
Большинство гео-тестов, которые я вижу, буксуют на данных, а не на статистике. До любой работы над дизайном нужно:
- KPI по регионам и дням из бэкенда. Заказы, кредитные заявки, одобренные кредиты, выданные полисы, депозиты: то, что бизнес считает результатом, с возможностью суммировать по регионам и дням. Не конверсии из отчётов платформ: руководство GeoX по внедрению требует сырые, нефильтрованные события конверсий, а не атрибутированные.¹⁰ Если KPI живёт в нескольких системах, статья про хранилище first-party данных рассказывает, как собрать его вместе.
- Один стабильный гео-ключ на запись. Решите, к какому региону относится заказ: адрес доставки, обслуживающее отделение, регистрация клиента или город по IP. Выберите одно, держите его как можно ближе к тому, как таргетируется реклама, и не смешивайте определения. Офлайн-конверсиям из отделений и колл-центра регион нужен из CRM.
- Расходы по регионам и дням для каждой платформы в тесте. У большинства рекламных платформ в отчётах есть разбивка по местоположению; до теста проверьте, что выгрузка работает на вашем уровне регионов и сходится с биллингом.
- Чистая история. Не меньше 52 недель со значением для каждого региона и даты (GeoLift не принимает пропуски), лучше два года, чтобы была видна сезонность.¹¹
- Журнал всего регионального. Локальные акции, открытия отделений, сбои, региональное ТВ. Рекомендации GeoLift требуют держать локальный маркетинг одинаковым в тестовых и контрольных регионах.¹¹
Как передать результат в MMM
Эксперимент измеряет один канал, в один период, на одном уровне расходов. MMM нужна кривая отклика этого канала за годы. Поэтому эксперимент информирует модель, но не заменяет её. Рабочие правила даёт плейбук Google:¹
- Сначала валидация, потом калибровка. Сравните ROI из MMM с iROAS эксперимента по тому же каналу, KPI и периоду. Расхождение 5-10% допустимо и действий не требует; выше 10% модель калибруют по эксперименту.
- Не калибруйте весь канал по одному эксперименту. Плейбук называет это типичной ошибкой и считает калибровку непрерывным процессом. Он же отмечает, что один эксперимент может быть хорошим источником prior, если канал ведётся одинаково и сезонность слабая: один тест может сформировать prior, но не должен диктовать ответ.
- Никогда не используйте один эксперимент и для валидации, и для калибровки одной модели. Как только результат попал в prior, для следующей валидации нужен новый тест.
- Двигайте бюджет шагами. Действуя по прогнозам MMM, перераспределяйте не больше 20% бюджета канала за раз, а изменения больше 10% по возможности проверяйте экспериментом.
- Тестируйте там, где модель меньше всего уверена. Следующий эксперимент получают каналы с самыми широкими интервалами ROI.
Как результат принимает каждая библиотека:
| Библиотека | Как входит эксперимент | Что используется | На что смотреть |
|---|---|---|---|
| Meridian 2.0+ | Prior по ROI для тестируемого канала, его строит CalibrationBuilder | Точечная оценка iCPD и её стандартное отклонение, расходы в обычном режиме, даты | Рассчитан на контрфактический сценарий с нулевыми расходами: holdback и go-dark подходят, heavy-up напрямую нет |
| Robyn | Строка calibration_input; MAPE.LIFT становится третьей целевой функцией | Только точечная оценка | Интервал игнорируется; тест должен лежать внутри окна модели |
| PyMC-Marketing | add_lift_test_measurements добавляет слагаемое в правдоподобие | Уровень расходов, изменение расходов, прирост и его стандартное отклонение | Естественно подходит для heavy-up |
Meridian
Meridian задаёт prior на ROI, а не на сырые коэффициенты, поэтому эксперимент переводится в prior напрямую. Начиная с версии 2.0 (сентябрь 2026) CalibrationBuilder принимает результат анализа GeoX и читает точечную оценку iCPD и её стандартное отклонение, оценку расходов в обычном режиме и даты анализа.¹² ¹³ Затем он поправляет три расхождения между тестом и моделью: уровень расходов (средние дневные расходы в эксперименте и в канале), давность (период полураспада 52 недели, старые тесты весят меньше) и длительность (короткий тест захватывает только часть эффекта adstock), объединяет несколько экспериментов байесовским обновлением и подгоняет параметрическое распределение prior.¹³ Документация прямо говорит, что builder рассчитан на lift-эксперименты, измеренные относительно нулевых расходов, и предупреждает, что ненулевой контрфактический сценарий создаёт несоответствие оцениваемых величин.¹³ У heavy-up контрфактический сценарий ненулевой, это обычные расходы, поэтому по той же логике он напрямую не подходит: 1,66 из нашего heavy-up ближе к предельной отдаче, чем к среднему ROI канала. Кроме того, на октябрь 2026 в changelog Meridian значится ещё не выпущенное исправление, которое выравнивает откалиброванные prior по ROI на бэкенде JAX с TensorFlow, так что перед тем как полагаться на откалиброванные prior на бэкенде по умолчанию, проверьте заметки к релизам.¹² Остальная настройка описана в статье про Meridian.
Robyn
Robyn принимает эксперименты строками calibration_input (channel, liftStartDate, liftEndDate, liftAbs, spend, confidence, metric, calibration_scope) и добавляет в поиск третью целевую функцию:¹⁴
- прирост, измеренный экспериментом k (liftAbs), - вклад этого канала в декомпозиции модели за то же окно, K - число экспериментов. По умолчанию к обычному отбору по Парето проходят только модели из лучших 10% по MAPE.LIFT.¹⁴ Руководство аналитика Robyn говорит, что калибровка принимает только точечную оценку,¹⁵ так что 33,2 тыс. $ входят как точное значение, а интервал от 23,0 до 43,4 тыс. $ теряется. В моём прочтении - это вклад канала относительно нулевых расходов, поэтому результаты holdback и go-dark сравниваются с ним естественно, а прирост heavy-up покрывает только дополнительные расходы, и передавать его как прирост всего канала не стоит.
PyMC-Marketing
Метод add_lift_test_measurements в PyMC-Marketing принимает канал, уровень расходов x, изменение расходов Δx, измеренный прирост Δy и его стандартное отклонение σ. Документация описывает lift-тест как две точки на кривой насыщения канала, а метод добавляет слагаемое в правдоподобие:¹⁶
Здесь f - кривая насыщения канала вместе с его коэффициентом β, и живёт она на гранулярности самой модели: один период (неделя в недельной модели) и, в региональной модели, один регион. Метод сравнивает две точки на этой кривой и не суммирует прогнозы по неделям эксперимента. Поэтому результат теста нужно пересчитать перед подачей, а не передавать итоги за окно. Для heavy-up из этой статьи это недельные значения: Δx = 20 / 4 = 5, Δy = 33,2 / 4 = 8,3 и σ = 5,24 / 4 ≈ 1,31 (тыс. $ в неделю), а x - обычные недельные расходы канала в тестовых регионах. В региональной модели передайте по строке на каждый тестовый регион и разделите прирост между ними, например пропорционально базе каждого региона; в национальной модели x и Δx должны быть в том же масштабе, что и национальные расходы, которые видит модель, потому что тест шёл только в части страны.
Недельный пересчёт опирается на два допущения, которые стоит проверить. Первое: расходы во время теста держались ровно. Второе: тест был длинным по сравнению с переносом эффекта канала, и расходы после adstock успели выйти на новый уровень: при нормированном adstock, который PyMC-Marketing использует по умолчанию, ровные недельные расходы x дают после adstock значение x. Перенос, который приходит уже после окна теста, в Δy не попадает вовсе, поэтому для медленно затухающих каналов пересчёт занижает эффект; для них важнее более длинный тест или период остывания внутри измеряемого окна, чем арифметика. Holdback или go-dark - та же конструкция с парой точек: 0 и недельные тестовые расходы. Для этих двух дизайнов есть и альтернатива на уровне окна: add_cost_per_target_calibration добавляет правдоподобие на ROAS или стоимость результата канала за период дат, так что iROAS теста можно задать на даты теста напрямую. Поэтому, если heavy-up ваш основной дизайн, PyMC-Marketing принимает его результат напрямую; остальные компромиссы разобраны в сравнении библиотек.
Цикл
Эксперимент и модель кормят друг друга: модель указывает на канал, в котором меньше всего уверена, эксперимент сужает неопределённость, и следующее обновление указывает уже на другой канал.
Гео-тест от вопроса до MMM
Тест не запускают, если MDE выше ожидаемого эффекта
Вопрос
Самый широкий интервал ROI в MMM
Гипотеза и KPI
Дизайн
Анализ мощности и MDE
Распределение регионов
- заморозить прочие изменения
Проведение
Период теста
Период остывания
Чтение и применение
Прирост с интервалом
Решение по бюджету
Prior или lift-член в MMM
- плацебо-вывод
Откалиброванная MMM подсказывает следующий канал для теста.
Meridian 2.0 помогает с первым шагом: его рекомендации по калибровке каналов оценивают каналы по неправдоподобно высокому или низкому ROI, широким posterior и проверке на возможное смещение по контрольным переменным и отмечают те, которым эксперимент даст больше всего.¹⁷
Чек-лист запуска
- Гипотеза записана вместе с решением: если iROAS выше порога, делаем X; если нет, делаем Y
- KPI определён и выгружен из бэкенда по регионам и дням, в том же определении, что и в MMM
- Гео-единицы определены, доступны для таргетинга на каждой платформе теста, KPI надёжно к ним привязан
- Чистый предтестовый период не меньше 3x (GeoX) или 4-5x (GeoLift) длины теста; 52 недели для сезонности
- Анализ мощности сделан: известны MDE и нужный бюджет, ожидаемый эффект выше MDE
- Дизайн выбран под вопрос и под то, как результат войдёт в MMM: holdback, go-dark или heavy-up
- Распределение стратифицированное или парное, роль крупнейших городов зафиксирована заранее, проверка A/A пройдена
- Таргетинг зафиксирован: только физическое присутствие, регионы таргетированы явно, на тех же кампаниях нет параллельных lift-исследований
- Список заморозки согласован: никаких замен регионов, переносов бюджета между регионами, локальные акции сбалансированы или записаны
- Тест идёт запланированный срок плюс последействие, без досрочной остановки
- Результат прочитан с интервалом и p-value, качество дизайна (подгонка, A/A, MDE) проверено до того, как ему доверять
- Решение принято по заранее согласованному порогу
- Результат передан в MMM как prior или lift-слагаемое либо отложен для валидации, и выбор записан
Ошибки, которые обесценивают гео-тест
Подглядывание и досрочная остановка
Если смотреть на результат каждые несколько дней и остановиться при первом «значимо», доля ложных срабатываний вырастает намного выше номинальных 10%. Ранний накопленный iROAS нестабилен по своей природе, это видно у Kerman и соавторов. Зафиксируйте дату окончания в плане и читайте результат один раз, после периода последействия.
Загрязнённые регионы и перетекание эффекта
Люди, которые живут в контрольном регионе, а работают в тестовом; адрес доставки, отличный от места, где увидели рекламу; таргетинг по местоположению в режиме «присутствие или интерес»; национальная кампания, которая протекает везде; brand lift-исследование на тех же кампаниях. Руководство GeoX требует таргетинг по физическому присутствию, явный таргетинг на каждый регион и отсутствие параллельных lift- и holdout-исследований. Перетекание обычно тянет измеренный эффект к нулю.
Слишком короткий предтестовый период
В сквозном примере 8 предтестовых недель на 4-недельный тест, это 2x, и точечная оценка промахивается мимо истинного эффекта на 13%. GeoX просит не меньше 3x длины теста, GeoLift 4-5x и не меньше 25 периодов. Предтестовый период со структурным сломом (смена цен, новая сеть отделений, изменение трекинга) хуже короткого, но чистого.
Конверсии платформ в роли KPI
Атрибутированные или смоделированные платформой конверсии учитывают только то, что платформа видит и засчитывает, поэтому тест в итоге измеряет атрибуцию платформы, а не ваш бизнес. Правила согласия и ограничения браузеров сужают этот обзор ещё сильнее, как объясняет статья про Consent Mode v2. Используйте сырые события бэкенда: заказы, заявки, полисы.
Изменение бюджетов или регионов посреди теста
Перенос бюджета из тестовых регионов в контрольные, добавление региона, потому что он отстаёт, запуск акции только в тестовых регионах: каждое такое действие ломает контрфактический прогноз. Руководство GeoX запрещает добавлять, убирать или менять местами регионы во время теста, а GeoLift требует держать все остальные медиа одинаковыми по рынкам.
Следующий шаг
Практический следующий шаг: выгрузите из бэкенда 52 недели основного KPI по регионам и дням и прогоните на них анализ мощности в GeoX или GeoLift. Уже это покажет, какие каналы вообще можно протестировать.
Источники
¹ Modern Measurement playbook: MEM guidelines and best practices - Google
² Measuring Ad Effectiveness Using Geo Experiments (Vaver, Koehler, 2011) - Google Research
³ Meridian GeoX: An Open-Source Framework for Precision and Efficiency in Geo Experiments (Ye, Sinn, Li, Jiao, 2026) - Google Research
⁴ google/meridian-geox - GitHub
⁵ facebookincubator/GeoLift - GitHub
⁶ Types of experiments - Meridian GeoX, Google for Developers
⁷ Estimating Ad Effectiveness using Geo Experiments in a Time-Based Regression Framework (Kerman, Wang, Vaver, 2017) - Google Research
⁸ Robust Causal Inference for Incremental Return on Ad Spend with Randomized Paired Geo Experiments (Chen, Au) - Annals of Applied Statistics 16(1), 2022; arXiv
⁹ The Augmented Synthetic Control Method (Ben-Michael, Feller, Rothstein) - Journal of the American Statistical Association 116(536), 2021
¹⁰ Implementation of geo testing - Meridian GeoX, Google for Developers
¹¹ GeoLift Best Practices - Meta Open Source
¹² Meridian CHANGELOG - GitHub
¹³ Set custom ROI priors using past experiments - Meridian, Google for Developers
¹⁴ Robyn features: calibration - Meta Open Source
¹⁵ Analyst's guide to MMM - Robyn, Meta Open Source
¹⁶ Lift test calibration - PyMC-Marketing documentation
¹⁷ Channel calibration recommendation and score - Meridian, Google for Developers
Частые вопросы
Можно ли провести гео-тест всего на двух городах, например Алматы в тесте и Астана в контроле?
Технически да: TBR работает с одним тестовым и одним контрольным регионом, так устроены тесты на подобранных рынках. Но ничто не защищает от событий, которые во время теста происходят в одном городе и не происходят в другом, например акции конкурента, местного праздника или сбоя, и всё это попадает в оценку. Если без этого никак, берите длинный чистый предтестовый период, проверяйте подгонку на нём, предпочитайте синтетический контроль из нескольких регионов одному контрольному городу и считайте результат ориентировочным.
Результат получился незначимым. Значит, канал не работает?
Нет. Это значит, что тест не дал достаточных свидетельств против нуля на выбранном пороге; он не показывает, что эффект нулевой или даже что он маленький: реальный эффект размером с MDE при мощности 80% всё равно пропускается примерно в одном случае из пяти. Смотрите на доверительный интервал: он показывает, какие размеры эффекта совместимы с данными. Если он захватывает и убыточные, и очень прибыльные значения, тест был слишком слабым для вашего решения. Оценку с её широким стандартным отклонением всё равно можно передать в Meridian как слабый prior, но не в Robyn, который воспримет точечную оценку как точную.
Как часто повторять гео-тест на одном и том же канале?
Эффект дрейфует вместе с креативами, конкуренцией и насыщением, поэтому результат теста стареет. Калибровка в Meridian снижает вес старых экспериментов с периодом полураспада 52 недели, а плейбук Google предлагает план обучения с гео-экспериментом раз в год и более лёгкими conversion lift-исследованиями между ними. На практике я перепроверяю крупный канал примерно раз в год и после любого заметного изменения уровня расходов или стратегии.
Можно ли протестировать гео-методом ТВ или наружную рекламу?
Наружную рекламу обычно да: она покупается по городам, поэтому holdback или go-dark по городам работает, если KPI привязан к тем же городам. Национальное ТВ по регионам не разделить, поэтому гео-тестом оно быть не может; плейбук Google предлагает анализ Causal Impact на периоде с рекламой и без неё или опору на MMM с честным широким prior. Региональное ТВ, где его можно купить отдельно, тестируется как любой региональный канал.
Нужны ли GeoX или GeoLift, или аналитик справится в таблице?
Точечная оценка TBR - это регрессия, которую можно посчитать в таблице, как показывает сквозной пример. Сложные части - дизайн и инференс: стратифицированное распределение с проверкой A/A, смоделированные мощность и MDE и интервалы, которые выдерживают автокорреляцию ряда KPI; в статье GeoX обычный t-тест давал более чем в десять раз больше ложных срабатываний, чем ожидается. Именно это дают библиотеки, поэтому для любого теста, от которого зависит бюджет, используйте одну из них.
Узнаёте свою воронку?
Две недели, фиксированный скоуп, доступы только на чтение. Находки и роадмап на 90 дней остаются у вас в любом случае.