Meridian - открытая байесовская модель маркетингового микса (MMM) от Google, на октябрь 2026 года актуальна версия 2.1.0. Затраты на внедрение она окупает, если у вас есть минимум два года недельных данных в разрезе регионов (три года, если есть только общенациональные итоги), несколько каналов, бюджет которых действительно менялся во времени, и человек, который читает диагностику раньше графиков. Её главная цифра, ROI, показывает, как канал отработал в среднем. Для решения о бюджете нужен предельный ROI, и в разобранном ниже примере канал с ROI 2,0 возвращает на следующий доллар только 0,667.
Где Meridian находится в октябре 2026
Meridian - библиотека на Python, которая обучает геоуровневую байесовскую иерархическую модель медиамикса.¹ Google открыла её для всех рекламодателей в январе 2025 года,² и она заменила LightweightMMM: репозиторий LightweightMMM переведён в архив с пометкой, что библиотека больше не поддерживается.³
Состояние релизов на октябрь 2026:
-
Версия. Последний релиз 2.1.0: в changelog датирован 17 сентября 2026, на PyPI с 25 сентября 2026. Версия 2.0.0 датирована 2 сентября 2026.⁴ ⁵
-
Что изменила 2.0. Вычислительный бэкенд по умолчанию сменился с TensorFlow на JAX, появилась калибровка priors по экспериментам на инкрементальность, например Meridian GeoX, и рекомендации, какие каналы калибровать.⁴
-
Что изменила 2.1. Декларативный словарь в
ModelSpec: окна калибровки и holdout (отложенная выборка) теперь задаются именами каналов, регионов и датами (DateRange,CalibrationSpec,HoldoutSpec), а не массивами индексов.⁴ -
Лицензия и окружение. Apache-2.0. README требует Python от 3.11 до 3.13 и рекомендует минимум один GPU; проект протестирован на GPU T4 с 16 ГБ памяти.⁶
-
Оценивание. Параметры сэмплируются алгоритмом No-U-Turn Sampler (NUTS), это метод Монте-Карло по схеме марковских цепей (MCMC). Он требователен к вычислениям, отсюда и рекомендация про GPU.⁶
-
2.1.0: последний релиз, сентябрь 2026
-
2 года: недельных данных по регионам, минимум
-
3 года: для модели только на национальных данных
-
1 GPU: рекомендуемый минимум для обучения
Модель развивает две статьи Google: Jin et al. (2017), где adstock и насыщение по Хиллу впервые собраны в байесовскую MMM,⁷ и Sun et al. (2017), где добавлена иерархия по регионам.⁸ Meridian добавляет охват и частоту, меняющийся во времени свободный член для тренда и сезонности, органические медиа и немедийные воздействия.¹ Вокруг библиотеки Google сейчас выпускает Meridian GeoX для геоэкспериментов и Scenario Planner - отчёт с интерактивными сценариями бюджета, который генерируется из ноутбука; в документации он всё ещё помечен как бета.⁹
Если MMM для вас в целом новая тема, начните с обзорной статьи серии: Marketing mix modeling: что измеряет MMM, как устроена модель и когда она окупается. Здесь вопрос уже: подходит ли вам Meridian и как читать её результаты, когда модель обучена.
- Подходит. Несколько каналов, данные по регионам. Несколько платных каналов, минимум два года недельных KPI и расходов по регионам, бюджет, который менялся во времени. Аналитик, который работает на Python и умеет читать диагностику апостериорного распределения.
- Подходит. Вы проводите или планируете эксперименты. Meridian задаёт priors на ROI, поэтому каждый геотест или lift-исследование напрямую входит в модель. Если вы тестируете, Meridian превращает тесты в систему измерений, а не в разовые отчёты.
- Не подходит. Короткая или ровная история. Меньше двух лет данных или каналы, которые каждую неделю работали на одном уровне. Тогда модели приходится достраивать сценарий нулевых расходов из своих допущений, и posterior в основном повторяет prior.
- Не подходит. Вопросы уровня кампаний. Meridian работает на уровне каналов, и Google не рекомендует строить модели на уровне кампаний. Решения по креативам и кампаниям - задача экспериментов на платформах и атрибуции.
Если команда работает на R или вам ближе другая философия моделирования, компромиссы разобраны в сравнении Meridian, Robyn и PyMC-Marketing.
Модель в нотации Meridian
Полная спецификация Meridian содержит блоки для платных медиа, органических медиа, немедийных воздействий и каналов с охватом и частотой.¹ Ядро, важное для большинства рекламодателей, выглядит так:
Здесь y - KPI в регионе g в неделю t, μ - общий для всех регионов эффект времени, τ - свободный член региона, z - контрольная переменная i с региональным коэффициентом γ, x - платные медиа канала i, β - региональный эффект этого канала, L - максимальный лаг, α, ec и slope - параметры затухания, полунасыщения и формы кривой канала, ε - ошибка.
Два замечания, прежде чем разбирать части. Первое про обозначения: в обзорной статье серии я обозначал геометрическое затухание через θ, а наклон кривой Хилла через s; в Meridian это α и slope, а буквой s обозначен номер лага, поэтому здесь я следую нотации Meridian. Второе про масштаб: KPI делится на население региона, затем центрируется к нулевому среднему и нормируется к единичному стандартному отклонению, а медиа приводятся на душу населения и делятся на медиану канала. Параметры поэтому живут в стандартизованной шкале, а не в долларах.¹⁰
Базовая линия: свободные члены регионов и эффект времени
Один регион служит опорным с τ = 0 (по умолчанию регион с наибольшим населением), каждый из остальных получает свой свободный член с prior Normal(0, 5).¹¹ Эффект времени μ - взвешенное среднее двух ближайших узлов (knots):
Здесь b - значения в узлах, ℓ(t) и u(t) - ближайшие узлы до и после недели t, w(t) - линейный вес, который больше у ближнего узла.¹ По умолчанию геомодель получает по узлу на каждую неделю: она может себе это позволить, потому что каждая неделя наблюдается во многих регионах. Национальная модель получает один узел, то есть общий свободный член без тренда, если не добавить узлы. Базовая линия меняется во времени, а эффективность медиа нет: Meridian не моделирует её как меняющуюся во времени.¹²
Adstock: перенос эффекта, нормированный
Здесь x - медиа в неделю t минус s, w - вес лага s, α от 0 до 1 - скорость затухания, L - максимальный лаг (max_lag, по умолчанию 8 недель). По умолчанию затухание геометрическое; альтернативный биномиальный вес подходит каналам, чей эффект сохраняется во второй половине окна. Документация советует max_lag от 2 до 10 недель для геометрического и от 4 до 20 для биномиального затухания; prior на α по умолчанию Uniform(0, 1).¹³
Деталь, которую часто упускают, - знаменатель. В обзорной статье серии один всплеск в 100 при затухании 0,6 со временем накапливается примерно до 250, потому что сырые геометрические веса в сумме дают 1/(1 − 0,6). Meridian делит на сумму весов, поэтому тот же всплеск распределяется по следующим неделям, но в сумме остаётся 100; величина эффекта целиком сидит в β. Полезное следствие: если канал работает с постоянным недельным уровнем x, его значение после adstock ровно x. Благодаря этому пример ниже точен в установившемся режиме.
Функция Хилла: насыщение
Здесь ec - уровень медиа, при котором эффект достигает половины максимума, slope задаёт форму: при значении 1 и ниже кривая вогнутая с самого начала, выше 1 она S-образная.¹⁴ По умолчанию Meridian применяет функцию Хилла к медиа после adstock, а для обычных каналов (без охвата и частоты) фиксирует slope = 1 через prior Deterministic(1). Документация объясняет причину: оптимизатор бюджета находит глобальный оптимум, только когда кривые вогнутые, а S-образные кривые могут мешать сходимости.¹¹ Prior на ec - TruncatedNormal(0,8; 0,8; 0,1; 10) в нормированной шкале, где ec = 1 означает полунасыщение на медианном ненулевом уровне медиа на душу населения.¹¹
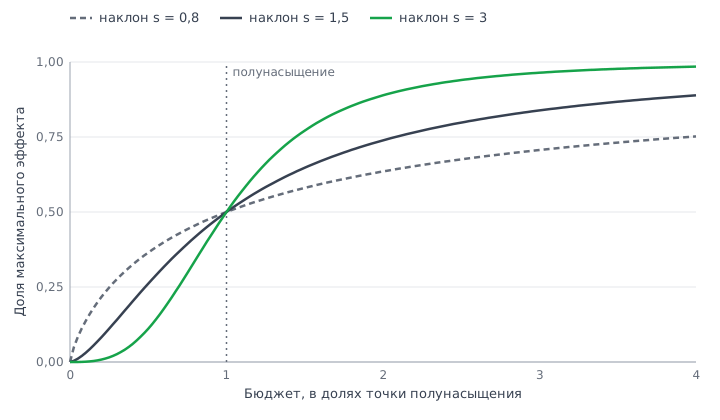
Документация добавляет предупреждение, которое стоит повторить: параметры Хилла оцениваются по тому диапазону бюджета, который вы реально наблюдали, а точки кривой за его пределами - экстраполяция.¹⁴
Иерархия по регионам
Каждый регион g получает свой эффект канала i, разбросанный вокруг среднего по каналу β с разбросом η. Это логнормальная форма по умолчанию, доступна и нормальная.¹ Prior на η - HalfNormal(1); документация описывает его как умеренную регуляризацию, которая поощряет объединение информации между регионами (pooling).¹¹ Контрольные переменные устроены так же: γ для региона g берётся из Normal(γ, ξ), но prior на ξ слабее стягивает регионы друг к другу. Затухание, ec и slope общие для всех регионов внутри канала. Проще говоря, у каждого региона свой эффект медиа, подтянутый к среднему по каналу, и маленькие регионы заимствуют силу у больших. Это идея Sun et al., и поэтому региональные данные дают более узкие интервалы, чем национальные.⁸
Правдоподобие
Остаток для региона g и недели t нормален со стандартным отклонением σ. По умолчанию у всех регионов один общий σ (unique_sigma_for_each_geo=False), поэтому маленькие шумные регионы могут сбивать подгонку; документация советует сначала отбрасывать самые маленькие регионы по KPI.¹⁵
Байесовский шаг в одном абзаце
Θ - все параметры модели, p(Θ) - prior (что вы считаете до данных), p(y | Θ) - правдоподобие, заданное моделью выше, p(Θ | y) - posterior, апостериорное распределение.¹⁶ Meridian получает выборку из posterior с помощью NUTS; пример в документации запускает 7 цепей с 1 000 шагов адаптации, 500 шагами прогрева и 1 000 сохранённых значений на цепь.¹⁷ Каждый результат, от ROI до кривых отклика, считается по каждому сэмплу, поэтому вы получаете распределение, а не число; по умолчанию сводки показывают 90-процентные интервалы достоверности (credible intervals). Когда в данных мало информации о канале, posterior остаётся близко к prior. Именно поэтому следующий раздел важнее любой другой настройки.
Каналы с охватом и частотой
Для каналов с охватом r и средней частотой f по региону и неделе Meridian заменяет показы таким слагаемым:¹⁸
Охват входит линейно, частота проходит через функцию Хилла, и здесь наклон оценивается по данным, поэтому кривая по частоте может быть S-образной. Priors на ec и slope для таких каналов подобраны так, что априорная оптимальная частота имеет среднее 2,1 и 90-процентный интервал от 1,0 до 4,4.¹¹ Охват должен быть числом уникальных людей за период (не накопленным), частота - показами, делёнными на охват, в той же сетке регион-неделя, что и KPI.¹⁸ На выходе получается оптимальная частота по каналу, то есть частота, максимизирующая ROI, одинаковая для всех регионов и недель; оптимизатор бюджета по умолчанию использует именно её.¹⁹ Для охвата и частоты YouTube документация отсылает к MMM Data Platform от Google; для других каналов нужны собственные данные в этой сетке.
Priors на ROI: настройка, которая важнее всех
Коэффициент β не имеет бизнес-смысла. Одно и то же β означает очень разный ROI для двух каналов, потому что ROI зависит ещё от стоимости единицы медиа, графика выходов, adstock и насыщения. Поэтому Meridian перепараметризует модель: prior ставится на ROI, а β выводится из него:²⁰
Здесь M - преобразованные медиа канала в единицах результата на единицу β (в нём учтено масштабирование по населению и KPI), а x с тильдой - расходы канала в регионе g в неделю t. Когда затухание, полунасыщение и региональные отклонения зафиксированы, β и ROI связаны взаимно однозначно, поэтому Meridian может сэмплировать ROI из prior и вычислять β.²⁰
Prior по умолчанию для каждого платного канала - LogNormal(0,2; 0,9). По формулировке документации, он задаёт средний ROI 1,83, половину массы выше 1,22, 80% между 0,5 и 6,0 и 95% между 0,25 и 9,0.¹¹ Эти два диапазона не совпадают с самим распределением: квантили LogNormal(0,2; 0,9) дают примерно от 0,39 до 3,9 для 80% и от 0,21 до 7,1 для 95% ( и ), а среднее 1,83 и медиана 1,22 верны. Постройте prior на графике, прежде чем на него опираться. Он одинаков для всех каналов, так что априори ни один канал не получает преимущества по ROI.
Почему это важно для калибровки: эксперимент измеряет дополнительный результат на единицу расходов, то есть ROI. С priors на ROI результат эксперимента можно прямо записать в prior. С priors на β так не получится.
Для платных медиа есть ещё три типа priors.²¹
| Тип prior | Что вы задаёте | По умолчанию | Когда использовать |
|---|---|---|---|
| ROI (по умолчанию) | Дополнительный результат на единицу расходов | LogNormal(0,2; 0,9) | Почти всегда; сюда подключаются эксперименты |
| mROI | Отдача от небольшого прироста расходов | LogNormal(0,0; 0,5) | Общий prior на mROI стягивает рекомендуемые сдвиги бюджета к историческому миксу |
| Contribution | Доля в общем результате | Beta(1, 99), среднее 1% | Органические медиа и немедийные воздействия (там это вариант по умолчанию) |
| Coefficient | Непосредственно β | HalfNormal(5) | Редко; сама Google редко его рекомендует |
Если KPI - не выручка и вы не передаёте выручку на единицу KPI, prior на ROI заменяется prior на суммарный вклад платных медиа со средним 40% и стандартным отклонением 20%.¹¹ Документация называет откалиброванный prior ограждением: слабые ограждения или их отсутствие соблазнительны, но без разумного prior модель может решить, что канал с маленьким бюджетом приносит огромную выручку.²²
Что prior и один эксперимент делают с каналом
Оба графика построены на смоделированном бренде из обзора MMM: два года недельных данных, три канала с известным истинным ROI (поиск 2,5, видео 1,8, наружка 1,2) и prior Meridian на ROI по умолчанию, LogNormal(0,2; 0,9), чей 90% интервал идёт от 0,28 до 4,69. Posterior посчитан на сетке с нормальным приближением правдоподобия данных, поэтому картинка точная и воспроизводимая; сам Meridian сэмплирует полную модель через NUTS.
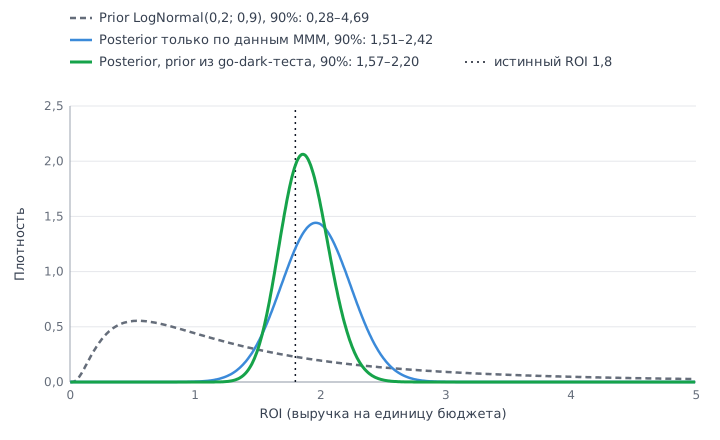
Видео всегда идёт в одни и те же недели высокого сезона, поэтому данные не могут полностью отделить его от сезонности: сами по себе они дают ROI 1,96 с 90% интервалом от 1,51 до 2,42. Калибровка заменяет prior по умолчанию на prior из эксперимента, в котором контрфактический сценарий - нулевые расходы. Здесь это смоделированный go-dark-тест: видео выключают на четыре недели в части страны, не тратят 60 тыс. $ и получают ROI 1,77 со стандартной ошибкой 0,25, то есть логнормальный prior с 90% интервалом от 1,39 до 2,21. С ним posterior сужается до интервала от 1,57 до 2,20, а среднее сдвигается с 1,96 до 1,88, ближе к истинному 1,8. Heavy-up вроде сквозного примера из статьи про гео-эксперименты здесь не подходит: он измеряет отдачу дополнительных расходов, а не средний ROI, который описывает prior.
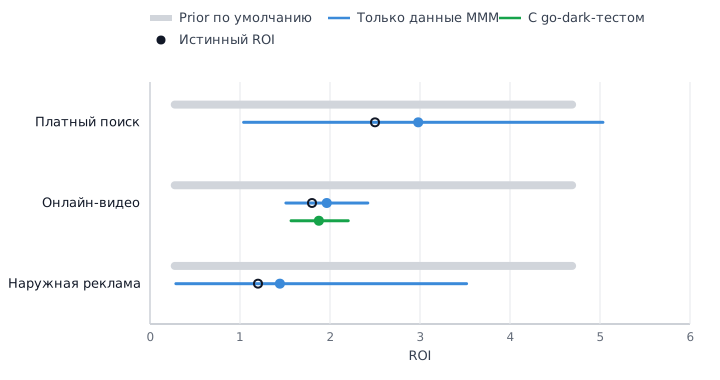
Просите такой вид в каждом отчёте. Бюджет поиска тоже движется вместе с сезоном, и его интервал остаётся широким, от 1,04 до 5,03. Бюджет наружки почти не меняется от недели к неделе, поэтому данные говорят мало: её интервал от 0,29 до 3,52 близок к интервалу prior от 0,28 до 4,69, то есть ROI наружки в таком отчёте - это в основном выбранный вами prior.
Какие данные нужны Meridian
| Параметр | Рекомендация Meridian |
|---|---|
| Гранулярность | Лучшая практика - недели; дни или месяцы допустимы, но дневные данные удлиняют расчёт, а месячные могут дать широкие интервалы или не сойтись |
| История, геомодель | Минимум два года недельных данных |
| История, национальная модель | Минимум три года |
| Только месячные данные | Минимум три года |
| KPI | Должен суммироваться по регионам и неделям (продажи, счета, конверсии); для ROI в деньгах нужна выручка или выручка на единицу KPI |
| Население | Обязательно по каждому региону, используется для масштабирования KPI и медиа |
| Медиа только на национальном уровне | Распределить по регионам пропорционально населению и всё равно строить геомодель |
| Уровень детализации | Каналы; модели на уровне кампаний не рекомендуются |
Источники для таблицы: страницы о сборе данных,²³ выборе регионов¹⁵ и достаточности данных.²⁴
На странице о достаточности данных есть два примера, которые стоит знать наизусть.²⁴
- 4: точки данных на параметр: 26 параметров на 104 недели, слишком мало
- около 15: после сокращения до 10 параметров на 156 неделях
- 16 380: регион-недель: 105 регионов × 156 недель
- от 8 до 74: точек на параметр без объединения и при полном объединении
В национальном примере 12 каналов, 6 контрольных переменных и 8 узлов, то есть 26 параметров на 104 недельных точках: четыре точки на параметр, что документация называет слишком малым для надёжной оценки. Если объединить каналы до трёх, оставить 2 узла, убрать контрольную переменную, которая не влияет на медиа, и взять три года, получится 156 точек на 10 параметров, примерно 15 на параметр; по документации этого хватает для информации о направлении эффектов. В геопримере 105 регионов за 156 недель. При строгом подсчёте, когда каждый регион оценивается независимо, это 2 094 параметра и около 8 точек на каждый; при полном объединении 222 параметра и около 74 точек на каждый. Частичное объединение даёт что-то посередине. Когда региональных данных мало, документация советует объединять или убирать каналы с маленьким бюджетом либо ставить более строгий prior, например HalfNormal(0,1) на разбросы η и ξ, чтобы подтолкнуть модель к объединению.²⁴
Перед обучением прогоните EDA-пакет Meridian. Он проверяет долю расходов, отношение данных к параметрам, критическое отсутствие вариации, выбросы, корреляцию медиа с населением, попарные корреляции, коэффициенты инфляции дисперсии (VIF), коллинеарность с эффектами региона и времени и априорную вероятность отрицательной базовой линии.²⁵
Процесс целиком
Meridian от начала до конца
Ничего не читают, пока не пройдена диагностика
Данные и EDA
Таблица регион-неделя
Вариация бюджетов по каналам
Проверка коллинеарности
Priors
Prior на ROI по каналу
Эксперименты как priors
- LogNormal(0,2; 0,9)
Оценка и диагностика
NUTS
max R-hat ниже 1,2
Предиктивная проверка
- не прошла: назад к данным
Чтение и решения
ROI, mROI
Кривые отклика
Сценарии бюджета
- следующий эксперимент
Каждый новый эксперимент становится prior при следующем переобучении.
- Проверка данных. Соберите одну таблицу регион-неделя (KPI, расходы и показы по каналам, контрольные переменные, население) и прогоните EDA. Исправьте каждую проваленную проверку, прежде чем думать о priors.
- Priors. Переведите результаты экспериментов в priors на ROI через калибровщик, для остального используйте экспертную оценку и стройте график каждого собственного prior.
- Обучение.
sample_prior, затемsample_posteriorс NUTS. Прореживание posterior ускоряет исследование, но документация прямо говорит, что для финальных результатов оно не годится.¹⁷ - Диагностика. Сформируйте карточку здоровья модели (следующий раздел). Провал отправляет вас назад к данным или priors, а не вперёд к графикам.
- Результаты. Дополнительный результат, ROI и предельный ROI с интервалами, кривые отклика, оптимальная частота для каналов с охватом и частотой.
- Сценарии бюджета. Фиксированный бюджет, целевой ROI или минимальный предельный ROI, с ограничениями расходов по каналам.
- Следующий эксперимент. Рекомендация по калибровке каналов называет каналы, где тест полезнее всего. Его результат возвращается в модель как prior при следующем переобучении.
Диагностика до чтения любых результатов
Meridian собирает проверки в карточку здоровья модели:²⁶
Каждая проверка возвращает статус pass (пройдено), review (проверить вручную) или fail (провал).
| Проверка | Что измеряет | Пройдено | Иначе |
|---|---|---|---|
| Сходимость | Max R-hat по всем параметрам: разброс между цепями против разброса внутри цепей | Ниже 1,2 | 1,2 и выше - провал: больше итераций, затем priors и коллинеарность |
| Отрицательная базовая линия | Апостериорная вероятность, что базовая линия, просуммированная за окно, отрицательна | Ниже 0,2 | От 0,2 до 0,8 - проверить; выше 0,8 - провал, модель переоценивает медиа |
| Апостериорный предиктивный p-value | Как часто симулированный суммарный результат так же экстремален, как наблюдаемый | 0,05 и выше | Ниже 0,05 - провал: модель задана неверно |
| Качество подгонки | R-квадрат, MAPE и взвешенный MAPE, также на holdout, если он задан | R-квадрат выше 0 | 0 и ниже - проверить: priors конфликтуют с данными |
| Сдвиг prior-posterior | Бутстреп-тест среднего, медианы и квартилей ROI против prior | Сдвиг по каждому каналу | Нет сдвига - проверить: данные слабые или prior намеренно сильный |
| Согласованность ROI | Апостериорное среднее ROI против 1-го и 99-го перцентилей вашего prior | Внутри | Снаружи - проверить |
Два пункта требуют комментария. Метрики подгонки нужны для сравнения моделей-кандидатов, а не для доказательства причинности: документация отмечает, что модель может получить высокий R-квадрат, подогнав общий тренд продаж и расходов, и записать органический рост в заслугу медиа.²⁶ И отсутствие сдвига prior-posterior нормально, когда prior взят из надёжного эксперимента, но тревожно, когда prior стоит по умолчанию: значит, модель ничего не узнала об этом канале.
С версии 2.0 в карточку здоровья входит и рекомендация по калибровке каналов. Meridian сводит четыре критерия в балл от 0 до 100 и отмечает каналы ниже 67,5: неправдоподобно высокий ROI с учётом доли расходов (порог по умолчанию 20), неправдоподобно низкий (по умолчанию 0,5), слишком широкий posterior ROI и возможное смещение.²⁷ Читайте её как бэклог экспериментов.
Как читать результаты
Дополнительный результат и вклад
Meridian сравнивает фактический результат с контрфактическим сценарием, в котором один канал обнулён, а всё остальное осталось как было. Разница - дополнительный (инкрементальный) результат канала; делённая на общий наблюдаемый результат, она даёт вклад.²⁸ Две оговорки из документации. ROI за период учитывает отложенный эффект более ранних расходов и не учитывает эффект расходов периода, который проявится после его окончания: за год это мелочь, за квартал уже заметно. А для канала, который работал всегда, модель ни разу не видела нулевых расходов, и контрфактический сценарий экстраполируется из её допущений.²⁸
ROI с интервалами достоверности
Сводная таблица показывает по каждому каналу: расходы, долю расходов, дополнительный результат, долю во вкладе, ROI, эффективность (дополнительный результат на показ), предельный ROI и стоимость дополнительной единицы KPI, по умолчанию с 90-процентными интервалами. Сначала читайте интервал, потом точку. Если интервал ROI канала накрывает 1, модель не знает, окупается ли канал, что бы ни говорило среднее. Такой канал - кандидат на тест, а не повод для решения о бюджете.
Предельный ROI и кривые отклика
Meridian строит кривую отклика, умножая исторические расходы канала на коэффициент и сохраняя его график выходов по регионам и неделям. Предельный ROI - это отдача от небольшого прироста δ, по умолчанию 1%:²⁸
Здесь R - кривая отклика канала (дополнительный результат как функция расходов), Cost - исторические расходы; оба определения предполагают постоянную стоимость единицы медиа. Для гладкой кривой это практически производная, поэтому пример можно посчитать вручную.
Пример. Возьмём канал с постоянными недельными расходами S, так что нормированный adstock равен S, с наклоном 1 по умолчанию, максимальной дополнительной выручкой 300 тыс. $ в неделю и точкой полунасыщения 50 тыс. $. Числа взяты из скрипта, по которому построены графики серии.
Здесь S - недельные расходы, r_max = 300 - максимальная недельная дополнительная выручка, ec = 50 - расходы, при которых достигается её половина, всё в тыс. $.
| Расходы в неделю S, тыс. $ | Дополнительная выручка R(S), тыс. $ | ROI = R(S) / S | mROI = 300 × 50 / (S + 50)² |
|---|---|---|---|
| 25 | 100 | 4,0 | 2,667 |
| 50 | 150 | 3,0 | 1,5 |
| 100 | 200 | 2,0 | 0,667 |
| 150 | 225 | 1,5 | 0,375 |
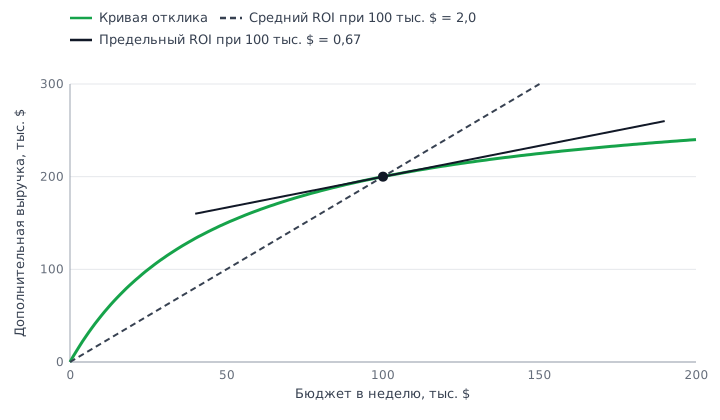
При 100 тыс. $ в неделю ROI говорит, что канал отличный: каждый вложенный доллар вернул два. Предельный ROI говорит, что следующий доллар вернёт 67 центов выручки. Приравняв mROI к 1, получаем расходы безубыточности по выручке:
Выше 72,5 тыс. $ в неделю каждый дополнительный доллар возвращает меньше доллара выручки, хотя средний ROI остаётся заметно выше 1. При 150 тыс. $ ROI всё ещё 1,5 и выглядит прибыльным, а предельный ROI равен 0,375. При 50 тыс. $ обе метрики говорят добавить бюджет: mROI равен 1,5. Метрики связаны простым тождеством: mROI = ROI × ec / (S + ec); при 100 тыс. $ это 2,0 × 50 / 150 = 0,667. Множитель - это ненасыщенная доля кривой, поэтому чем дальше канал продвинулся по своей кривой, тем сильнее его средний ROI завышает ценность следующего доллара. Это отношения по выручке: если вы решаете по валовой прибыли с маржой m, условие безубыточности - mROI = 1/m, и оптимальные расходы сдвигаются ниже.
Сценарии оптимизации бюджета
- По умолчанию. Фиксированный бюджет. Сохраняет общую сумму (по умолчанию историческую) и перераспределяет её, максимизируя ожидаемый результат. Каждый канал ограничен диапазоном от 70% до 130% своих исторических расходов, если не изменить
spend_constraint_lowerиspend_constraint_upper. - Гибкий. Целевой ROI. Находит максимальный бюджет, при котором суммарный ROI маркетинга остаётся на целевом уровне. Ограничение действует на итог, а не на каждый канал. Границы по умолчанию расширяются до диапазона от 0% до 200% исторических расходов.
- Гибкий. Минимальный предельный ROI. Позволяет расходам расти, пока предельный ROI каждого канала выше заданного порога. Ограничение действует на каждый канал, поэтому этот сценарий ближе всего к логике безубыточности выше.
Все сценарии предполагают исторический график выходов и стоимость единицы медиа, оптимизируют апостериорное среднее ожидаемого результата и не учитывают отложенный эффект, который приходится на время после окна оптимизации.²⁹ ³⁰ Для каналов с охватом и частотой оптимизатор предполагает, что кампании идут с оптимальной частотой, если не задать use_optimal_frequency=False.¹⁹
Калибровка Meridian экспериментами
От результата эксперимента к prior на ROI
В версии 2.0 появился калибровщик, который превращает результаты тестов на инкрементальность в priors на ROI за четыре шага: регистрация экспериментов, корректировка каждого, объединение и подгонка распределения.³¹ Результат Meridian GeoX можно зарегистрировать напрямую: калибровщик сам берёт точечную оценку и стандартное отклонение дополнительных конверсий на доллар (iROAS, если KPI - выручка), оценку обычных расходов (business as usual) и даты. Любой другой эксперимент регистрируется с точечной оценкой, стандартной ошибкой, расходами и датами.
Перед тем как стать свидетельством о канале в MMM, каждый эксперимент корректируется:
Здесь μ и σ - точечная оценка и стандартная ошибка эксперимента, слагаемые γ масштабируют оценку, слагаемые τ увеличивают дисперсию; это калибровочные множители, и с γ (контрольные переменные) и τ (свободные члены регионов) самой модели они не связаны.³¹ Слагаемое расходов растёт тем сильнее, чем больше средние дневные расходы эксперимента отличаются от средних дневных расходов канала в окне модели. Слагаемое длительности делит оценку короткого теста на p, долю веса adstock, попавшую в окно теста, и расширяет её на (1 − p)/p; калибровщик по умолчанию считает затухание геометрическим с α = 0,5 и максимальным лагом 8. Слагаемое давности использует период полураспада 52 недели:
Здесь w - число недель между окончанием эксперимента и последней неделей модели. Эксперимент, закончившийся за 52 недели до конца окна модели, получает λ = 0,5 и слагаемое давности 1, то есть уже только оно увеличивает стандартную ошибку в √2 раз.³¹ Несколько экспериментов по одному каналу затем объединяются байесовским обновлением:
Здесь π - необязательный базовый prior (если его не задать, берётся плоский по положительным значениям), N - число экспериментов. Калибровщик считает это распределение на сетке и подгоняет к нему LogNormal, Gamma или Normal; результат становится prior на ROI канала.³¹ Документация прямо говорит, что точной формулы здесь нет: эксперименты и MMM определяют ROI на разных окнах, регионах и настройках кампаний, и prior должен нести эту дополнительную неопределённость.²²
Что на практике изменили 2.0 и 2.1
- 2.0 сделала калибровку полноценным шагом процесса (калибровщик и рекомендации по калибровке каналов) и переименовала
max_rhatвmax_r_hat.⁴ - 2.1 позволяет ограничить prior на ROI окном эксперимента через имя канала и даты (
CalibrationSpec,DateRange) вместо массивов индексов и сохраняет случайный holdout вместе с моделью. Документация по-прежнему рекомендует задавать prior на всё окно моделирования, когда это возможно.²⁰ - Оговорка для 2.1.0 на JAX. В changelog указано ещё не выпущенное исправление, чтобы откалиброванные priors на ROI на бэкенде JAX совпадали с TensorFlow. Если калибруете на 2.1.0, постройте графики получившихся priors до обучения.⁴
Ловушка оцениваемой величины: тесты с увеличением бюджета
Meridian GeoX поддерживает три вида воздействия: holdback (новые расходы в тестовой группе, ноль в контрольной), go-dark (существующие расходы в тестовой группе отключаются) и heavy-up (дополнительные расходы поверх обычных); документация GeoX позиционирует heavy-up как способ прогнозировать предельную отдачу от увеличения бюджета.³² Калибровщик рассчитан на прирост, измеренный против сценария нулевых расходов, и документация не рекомендует регистрировать результаты, измеряющие предельный прирост, из-за несовпадения оцениваемых величин.³¹
Геотест в статье Геоэксперименты: GeoX и GeoLift - это четырёхнедельный heavy-up: 20 тыс. $ дополнительных расходов дали 33,2 тыс. $ дополнительной выручки, iROAS 33,2 / 20 = 1,66. Это число описывает наклон кривой выше текущих расходов и по смыслу ближе к предельному ROI, чем к среднему ROI канала. Если записать 1,66 в prior на ROI, вы смешаете две величины. Для prior на ROI проводите go-dark тест на существующем канале или holdback на новом. Результат heavy-up всё равно полезен как проверка предельного ROI модели или как вход для prior на mROI, если выбрать этот тип prior; последнее - моё суждение, а не задокументированный рецепт.
Meridian в Казахстане и СНГ
Около 20 регионов, очень неравных
В Казахстане 17 областей и три города республиканского значения (Алматы, Астана, Шымкент): около 20 географических единиц против 50-100 DMA, которые Google советует моделировать американским рекламодателям.¹⁵ Два года недельных данных дают 20 × 104 = 2 080 регион-недель, и в большинстве потребительских бизнесов Алматы и Астана несут непропорционально большую долю KPI. Документация говорит, что преимущество геомоделирования снижается, когда регионов относительно мало, и что лучше моделировать на более мелкой гранулярности, отбросив самые маленькие регионы, чем объединять их в крупные.¹⁵ При общем σ по умолчанию маленькие шумные области могут сбивать подгонку; отдельный σ для каждого региона доступен, но может затруднить сходимость.
Что бы сделал я:
- Геомодель по областям и городам, если KPI и большую часть расходов на медиа можно привязать к регионам. Отбрасывайте или объединяйте только самые маленькие единицы по KPI, передайте официальную численность населения для масштабирования и проверьте тест EDA на корреляцию с населением. Регион с наибольшим населением по умолчанию станет опорным.
- Национальная модель, если KPI нельзя надёжно привязать к регионам или большая часть бюджета - национальное ТВ, наружная реклама и размещения в Telegram без разбивки по регионам. Тогда закладывайте три года недельных данных, объединяйте каналы до нескольких и держите мало узлов, как в примере документации с сокращением от 26 до 10 параметров.
- Проверьте историю карты. В 2022 году созданы три новые области. Если история в CRM старше, переразметьте старые адреса на текущие единицы до сборки таблицы.
Каналы, KPI и офлайн-конверсии
Поисковые и социальные платформы обычно выгружают расходы и показы по регионам; проверьте региональную разбивку каждой платформы, которую вы используете в Казахстане, прежде чем строить геомодель. ТВ, наружная реклама и размещения в Telegram-каналах обычно покупаются на всю страну или по городам, поэтому работает совет документации: распределите национальные медиа по регионам пропорционально населению и смиритесь с тем, что о таких каналах модель узнает меньше.²³ Каналы с маленьким бюджетом лучше объединять, чем оценивать каждый отдельно.
У банков и суперприложений KPI, который имеет значение (открытые счета, выданные кредиты, активированные карты), завершается в отделении, колл-центре или приложении. Берите этот результат как KPI, привязывайте его к регионам по одному правилу (регион клиента или регион отделения, но не смесь) и передавайте выручку на единицу KPI, если нужен ROI в деньгах. Как довести результаты из отделений и колл-центра до аналитики, разобрано в статье Офлайн-атрибуция для банков; почему лиды - неверный KPI, когда бизнес-результат - выдача, - в статье Лиды из Google Ads без выдач; а сама таблица регион-неделя должна жить в хранилище данных, см. First-party данные в DWH.
Вычисления
README рекомендует минимум один GPU и не имеет официальной поддержки GPU на macOS; установка на CPU работает, но сэмплирование медленнее.⁶ Для прототипа хватит облачного ноутбука с GPU: собственные стартовые материалы Google - это ноутбук Colab. Для регулярного переобучения используйте облачную виртуальную машину с GPU NVIDIA. На вход модели идёт агрегированная таблица регион-неделя без пользовательских данных, поэтому разговор с комплаенсом обычно короче, чем для данных атрибуции, но служба безопасности банка всё равно должна согласовать, где она запускается.
Эксперименты на 20 регионах
Геоэксперименты упираются в то же ограничение: при примерно 20 единицах и двух доминирующих городах у стратифицированных дизайнов GeoX мало вариантов, поэтому готовьтесь к более длинным тестам или большему минимальному обнаружимому эффекту. Варианты разобраны в статье Геоэксперименты: GeoX и GeoLift.
Ошибки, которые стоят денег
Читать ROI как предельный ROI
«Масштабируйте канал с лучшим ROI» ранжирует каналы по средней отдаче. В примере выше канал с ROI 2,0 возвращает 0,667 на следующий доллар, и его расходы безубыточности - 72,5 тыс. $ в неделю, не больше. Бюджет двигают по предельному ROI и кривой отклика.
Priors по умолчанию на коротких данных
При двух годах национальных данных и дюжине каналов данные не могут далеко увести posterior от LogNormal(0,2; 0,9). Результат выглядит как измерение, но в основном повторяет prior: все каналы получают примерно одинаковый ROI. Смотрите график prior-posterior; каналам без сдвига нужен эксперимент или объединение, а не презентация.
Пропустить карточку здоровья
При max R-hat 1,2 и выше цепи не согласуются, и каждое следующее число, включая выдачу оптимизатора, ненадёжно. Вероятность отрицательной базовой линии выше 0,8 означает, что медиа приписан лишний эффект. Исправьте это до того, как кто-то увидит графики.
Перекинуть половину бюджета за раз
Руководство Google по современным измерениям рекомендует менять не больше 20% бюджета канала за раз.³³ Границы Meridian по умолчанию для фиксированного бюджета и так ±30%. Сдвиг на 50% выводит каналы на уровни расходов, которых модель никогда не видела, где кривая - экстраполяция. Двигайте до 20%, наблюдайте, переобучайте, тестируйте.
Калибровать ROI тестом heavy-up
Heavy-up измеряет отдачу от дополнительных расходов сверх текущего уровня. Калибровщик предполагает сценарий нулевых расходов. Для priors на ROI используйте go-dark или holdback, и не позволяйте одному эксперименту определять весь канал; руководство Google тоже называет это ошибкой.³³
Какой канал тестировать первым
Возьмите рекомендацию по калибровке каналов, отсортируйте отмеченные каналы по расходам и тестируйте самый крупный, у которого интервал ROI накрывает 1. Там эксперимент меняет больше всего денег.
Следующий шаг
Практический следующий шаг: соберите таблицу регион-неделя, прогоните по ней EDA Meridian и выпишите, по каким каналам уже есть эксперимент, который может стать prior на ROI.
Источники
¹ Model specification - Meridian, Google for Developers
² Meridian is now available to everyone - Google Blog
³ LightweightMMM README - Google, GitHub
⁴ Meridian CHANGELOG - Google, GitHub
⁵ google-meridian release history - PyPI
⁶ Meridian README - Google, GitHub
⁷ Jin, Wang, Sun, Chan, Koehler (2017). Bayesian Methods for Media Mix Modeling with Carryover and Shape Effects - Google Research
⁸ Sun, Wang, Jin, Chan, Koehler (2017). Geo-level Bayesian Hierarchical Media Mix Modeling - Google Research
⁹ Meridian Scenario Planner - Meridian, Google for Developers
¹⁰ Input data and scaling - Meridian, Google for Developers
¹¹ Default prior distributions - Meridian, Google for Developers
¹² Refresh the model - Meridian, Google for Developers
¹³ Set the adstock_decay_spec parameter - Meridian, Google for Developers
¹⁴ Media saturation and lagging - Meridian, Google for Developers
¹⁵ Geo-level modeling and geo selection - Meridian, Google for Developers
¹⁶ Bayesian inference - Meridian, Google for Developers
¹⁷ Run the model - Meridian, Google for Developers
¹⁸ Reach and frequency - Meridian, Google for Developers
¹⁹ Optimize frequency - Meridian, Google for Developers
²⁰ ROI, mROI and contribution parameterizations - Meridian, Google for Developers
²¹ Choose and configure treatment prior types - Meridian, Google for Developers
²² Calibrate treatment priors - Meridian, Google for Developers
²³ Collect and organize your data - Meridian, Google for Developers
²⁴ Amount of data needed - Meridian, Google for Developers
²⁵ Perform exploratory data analysis - Meridian, Google for Developers
²⁶ Model health checks - Meridian, Google for Developers
²⁷ Channel calibration recommendation and score - Meridian, Google for Developers
²⁸ ROI, mROI and response curves - Meridian, Google for Developers
²⁹ Budget optimization scenarios - Meridian, Google for Developers
³⁰ Optimization without reach and frequency - Meridian, Google for Developers
³¹ Set custom ROI priors using past experiments - Meridian, Google for Developers
³² Types of experiments - Meridian GeoX, Google for Developers
³³ Modern Measurement Playbook (2024) - Think with Google
Частые вопросы
Можно ли запускать Meridian без GPU?
Да. Установка на CPU работает, как и на macOS, где официальной поддержки GPU нет; просто сэмплирование идёт медленнее. README рекомендует минимум один GPU и указывает, что проект тестировали на T4 с 16 ГБ, поэтому для регулярного переобучения геомодели среда с GPU реально экономит время. На этапе исследования прореживание posterior сокращает вычисления, но отчитываться стоит только по полному posterior.
Наш KPI - открытые счета или выданные кредиты, а не выручка. Meridian подойдёт?
Да. KPI должен только суммироваться по регионам и неделям. Если передать выручку на единицу KPI, ROI будет в деньгах; если нет, Meridian заменяет prior на ROI по каналам prior на суммарный вклад платных медиа (среднее 40%, стандартное отклонение 20%), а prior на mROI тогда нужно задавать самостоятельно.
Как часто переобучать модель?
Google советует ритм, совпадающий с вашими бюджетными решениями, например раз в квартал или раз в год. Добавляйте новые недели к старым данным, а не моделируйте новый период отдельно, и держите окно около двух-трёх лет. Meridian не делает эффективность медиа меняющейся во времени, поэтому окно - это компромисс: длинная история снижает дисперсию, но может добавить смещение, если каналы изменились, а отбрасывание старых недель убирает это смещение ценой большей дисперсии. Перенос старого posterior в новые priors учитывает старые данные дважды.
Не завышает ли Meridian каналы Google?
Код модели открыт и не зависит от канала: каждый платный канал получает одинаковый prior на ROI по умолчанию, а спецификацию и priors можно прочитать самому. Практическая асимметрия - в данных: для охвата и частоты YouTube документация отсылает к MMM Data Platform от Google, а для других каналов сопоставимые данные придётся собирать самим. Настоящая защита от смещения в любую сторону - калибровка каждого крупного канала собственным экспериментом.
Мы уже используем LightweightMMM. Нужно ли переходить?
На практике да: репозиторий LightweightMMM в архиве, а README прямо говорит, что библиотека больше не поддерживается. Развитие продолжается в Meridian: там priors на ROI, охват и частота, калибровка экспериментами и карточка здоровья модели, а README Meridian ссылается на руководство по миграции. Результаты будут отличаться, поэтому один раз прогоните обе модели на одних данных и объясните расхождения, прежде чем переключать отчётность.
Узнаёте свою воронку?
Две недели, фиксированный скоуп, доступы только на чтение. Находки и роадмап на 90 дней остаются у вас в любом случае.