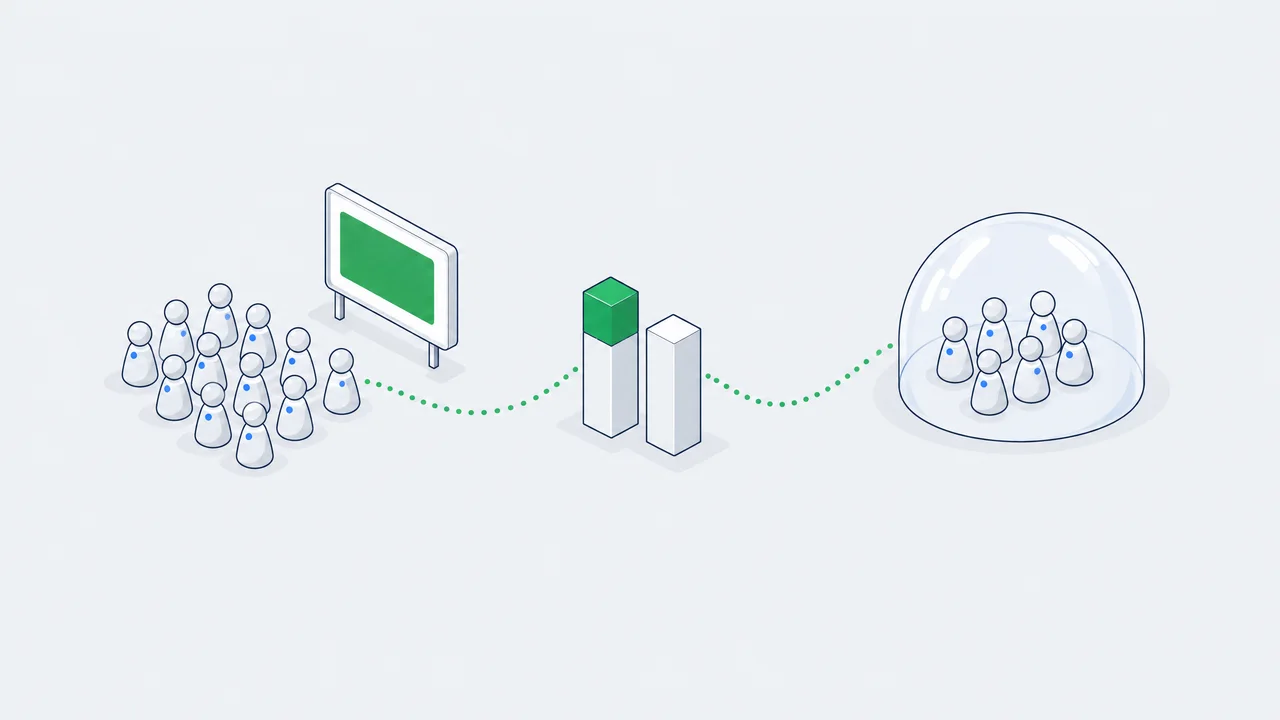
Исследование Brand Lift - единственная цифра в отчёте по охватной кампании, которая получена из эксперимента, а не из лога показов. Платформа не показывает рекламу случайной части вашей аудитории, опрашивает обе группы и сообщает разницу. Ответ узкий: ответили ли люди, которые могли увидеть рекламу, на один вопрос опроса иначе, чем те, кто увидеть её не мог.
Узкий ответ - это нормально. Проблемы начинаются, когда результат читают. «+13% brand lift» и «+4 п.п.» могут быть одним и тем же исследованием, «No lift detected» обычно значит «слишком мало ответов», а не «реклама не сработала», а лифт, найденный в одной возрастной группе из восемнадцати срезов, скорее шум, чем инсайт.
Все требования платформ ниже проверены 5 октября 2026 года по справочным страницам самих платформ. Они меняются, перепроверьте перед планированием.
Что это за исследование на самом деле
Три шага, и необычен только первый: холдаут, один опрос для обеих групп, вычитание.
Аудитория кампании
- все, кому реклама может быть показана
Холдаут, выбранный случайно
- отложен до первого показа и рекламу не получает
Один вопрос для обеих групп
- та же формулировка, тот же плейсмент: «О каких из этих брендов вы слышали?»
Лифт
- доля положительных ответов в тестовой группе минус доля в холдауте
Разбиение случайное, поэтому группы отличаются только одним: могла ли реклама до них дойти. Этим исследование Brand Lift отличается от опроса «до/после», где на цифру вместе с рекламой влияют сезон, запуск конкурента и ваш собственный PR.
Google Ads и YouTube
Контрольная группа - люди, которым реклама могла быть показана, но показана не была.²
Meta
Выборка из подходящей аудитории случайно делится на тестовую группу и холдаут. В тесте с одной ячейкой холдаут составляет 10% от размера тестовой группы, а в отчёте масштабируется.⁵
Яндекс Директ
Приглашают более 10 000 пользователей, половина в тестовой группе, половина в контрольной. Контрольная группа строится через «виртуальный аукцион»: эти люди выиграли аукцион на показ вашей рекламы, но вместо неё увидели опрос.⁹
TikTok
Две рандомизированные группы, тестовая и контрольная, набираются из части целевой аудитории и измеряются опросом в ленте.⁸
Пять чисел из одного эксперимента
Каждая платформа показывает какой-то набор из одних и тех же пяти показателей. Все они получаются из двух долей: доли положительных ответов в тестовой группе, ниже она обозначена pe, и той же доли в контрольной группе, pc. Вторую Google называет базовым уровнем.
Абсолютный лифт - это разница в процентных пунктах (п.п.). Относительный лифт делит её на базовый уровень. Headroom-лифт делит её на долю тех, кого ещё можно было завоевать: всех, кто ещё не отвечал положительно. Это определения Google.³ Яндекс использует те же формулы абсолютного и относительного лифта, а lifted users называет «Uplift-охват».¹⁰ Meta показывает разницу в пунктах как «brand lift percent», а число людей как «brand lift».⁶
Разберём пример. Цифры условные, подобраны так, чтобы их было легко проверить:
- Охват кампании: 1 200 000 человек. Расход: 6 000 000 ₸.
- Вопрос: «О каких из этих брендов вы слышали?»
- Контрольная группа: 2 000 ответов, 600 положительных. Базовый уровень 30,0%.
- Тестовая группа: 2 000 ответов, 680 положительных. Доля в тестовой группе 34,0%.
| Показатель | Расчёт | Результат |
|---|---|---|
| Абсолютный лифт | 34,0% - 30,0% | 4,0 п.п. |
| Относительный лифт | 4,0 / 30,0 | 13,3% |
| Headroom-лифт | 4,0 / 70,0 | 5,7% |
| Lifted users | 4,0% × 1 200 000 | 48 000 |
| Стоимость одного lifted user | 6 000 000 ₸ / 48 000 | 125 ₸ |
Три «лифта» - 4,0; 13,3 и 5,7 - описывают один результат. Автор отчёта выберет тот, что выглядит лучше, поэтому решите, какой из них читаете вы, до того как откроете отчёт.
Насколько это надёжно
Эти 4,0 п.п. получены на 4 000 человек, а не на 1 200 000. Опросите другие 4 000, и число выйдет немного другим. Насколько другим, показывает стандартная ошибка разницы:
Для цифр выше SE = 1,47 п.п. В отчётах Google используется двусторонний интервал 80%, который сам Google объясняет так: с вероятностью 90% истинный лифт выше нижней границы.³ Этот интервал равен лифту плюс-минус 1,2816 стандартной ошибки:
- Лифт: 4,0 п.п., интервал от 2,1 до 5,9.
- Lifted users: 48 000, интервал от 25 335 до 70 665.
- Стоимость одного lifted user: 125 ₸, в диапазоне от 85 ₸ до 237 ₸.
Google также показывает «уверенность», которая определена как единица минус p-value.³ Здесь z-оценка равна 2,71, а уверенность - односторонняя величина, которая согласуется с нижней границей этого интервала, - составляет 99,7%. Meta показывает уровень доверия в процентах и считает надёжным результат выше 90%.⁶
Теперь оставим те же доли и сократим выборку до 400 ответов на группу: 136 из 400 против 120 из 400. Лифт по-прежнему 4,0 п.п. Стандартная ошибка равна 3,30 п.п., интервал идёт от -0,2 до 8,2, а уверенность составляет 88,8%. Интервал включает ноль, поэтому платформа пишет «No lift detected».
Тот же креатив, те же медиа, тот же реальный эффект. Изменилось только число ответивших. Google сам проводит границу: «Not enough data», когда ответов меньше минимума, и «No lift detected», когда ответов хватило, а статистически значимой разницы нет.³ Ни один из статусов не говорит, что лифт был нулевым.
Прогоните свой отчёт через ту же арифметику:
Калькулятор Brand Lift
Открывается с числами из примера. Подставьте цифры из своего отчёта.
Лифт обнаружен. С вероятностью 90% настоящий лифт выше 2,1 п.п.
Сколько ответов нужно исследованию
Нужную выборку можно посчитать до запуска. Для одностороннего теста на уровне 90% с мощностью 80% (zα = 1,2816 и zβ = 0,8416) число ответов в каждой группе равно:
При базовом уровне 30%:
| Лифт, который нужно обнаружить | Ответов на группу | Ответов всего |
|---|---|---|
| 1 п.п. | 19 111 | 38 222 |
| 2 п.п. | 4 821 | 9 642 |
| 3 п.п. | 2 161 | 4 322 |
| 4 п.п. | 1 226 | 2 452 |
| 5 п.п. | 791 | 1 582 |
Если лифт, который вы хотите увидеть, вдвое меньше, выборка нужна вчетверо больше. Поэтому маленькие флайты возвращаются ни с чем.
Линии на графике - это формула. Точки проверяют её симуляцией: по 2 000 смоделированных исследований на каждый размер выборки, в которых лифт действительно есть. При 1 226 ответах в группе лифт в 4 п.п. нашли 81,8% из них, при 4 821 ответе лифт в 2 п.п. нашли 79,6%. Оба числа ложатся на обещанные формулой 80%.
Плановые цифры самого Google лежат в том же диапазоне. По справке Google Ads, сильной кампании нужно около 2 000 ответов на метрику, кампании с рекомендуемым минимальным бюджетом - около 4 100, а если после 16 800 ничего не видно, лифт, возможно, обнаружить нельзя.³ Таблица Display & Video 360 даёт от 1 200 до 2 800 ответов для лифта выше 4 п.п., от 5 000 до 11 000 для 2 п.п. и от 20 000 до 45 000 для 1 п.п.⁴
Ответы покупаются охватом, а охват - бюджетом. Отсюда минимумы платформ, и поэтому каждый дополнительный вопрос стоит дороже: каждому вопросу нужны свои ответы.
Исследование, в котором лифта нет
Тесту можно доверять, если он молчит, когда ничего не произошло. Проверяют это так же, как команда измерений Google проверяет собственный фреймворк гео-экспериментов: прогоняют анализ много раз на данных, где настоящий эффект равен нулю, и смотрят на p-value. Без эффекта они должны распределяться равномерно между 0 и 1, и тогда порог в 10% пересекается в 10% случаев.¹²
Я проверил так тест из этой статьи: 4 000 смоделированных исследований, в которых обе группы отвечают «да» в 30,0% случаев, а ответы приходят по 143 в день на группу в течение 14 дней.
| Как читают исследование | Доля исследований с «лифтом» | Сколько должно быть |
|---|---|---|
| Один раз, на 14-й день | 10,2% | 10% |
| Каждый день со 2-го, до первого «лифта» | 29,4% | 10% |
Прочитанный один раз, тест ошибается ровно так часто, как положено одностороннему тесту на уровне 90%. При ежедневном чтении тот же тест на тех же данных почти утраивает число ложных лифтов, хотя в кампании ничего не изменилось. Тринадцать взглядов на накапливающиеся ответы - это тринадцать шансов для шума пересечь порог, а в первые дни измеренная цифра далека от нуля даже там, где лифта нет совсем.
Назначьте день, когда вы прочитаете исследование, до его старта, и читайте в этот день. Та же арифметика относится к срезам: каждый лишний взгляд и каждый лишний срез - ещё одна попытка для того же шума.
Что требует каждая платформа
| Google Ads / YouTube | Meta | TikTok | Яндекс Директ | |
|---|---|---|---|---|
| Как получить | Через представителя Google, который ведёт аккаунт¹ | Brand survey test в Experiments или управляемое исследование через представителя Meta; только в отдельных регионах⁷ | Только через аккаунт-менеджера⁸ | В настройках медийной кампании⁹ |
| Минимальный бюджет | Казахстан входит в группу с самым низким порогом: $5 000 за 1 вопрос, $10 000 за 2, $20 000 за 3, потратить нужно за первые 10 дней¹ | Зависит от страны. Казахстана в списке нет; для стран вне списка по умолчанию $15 000⁵ | Не публикуется | 4 000 000 ₸ за период и 285 500 ₸ в день без НДС, охват не менее 3 млн пользователей⁹ |
| Вопросы | До 3: ad recall, знание бренда, ассоциации, рассмотрение, отношение к бренду, намерение купить, свой вопрос¹ | До 3. Ad recall обязателен; плюс знание бренда, отношение к бренду, знакомство с брендом, готовность рекомендовать⁷ | В справке не опубликовано | 3 из 6: знание бренда, ad recall, намерение купить, рассмотрение, отношение к бренду, запоминаемость рекламного сообщения⁹ |
| Длительность | Стандартное исследование завершается за срок от 3 до 14 дней¹ | Не менее 2 недель, до 90 дней⁷ | Не публикуется | Не менее 14 полных дней; рекомендуется от 2 до 4 недель⁹ |
| Как показана уверенность | Уверенность = 1 - p-value; интервал 80%³ | Уровень доверия в процентах; выше 90% считается надёжным⁶ | Не публикуется | Уровень доверия не указан¹⁰ |
Бюджет считается суммой по всем кампаниям исследования и пересчитывается в валюту аккаунта. Если предыдущее исследование закончилось статусом «No lift» или «Not enough data», Google предлагает исследование Enhanced: минимальный бюджет в три раза больше, от 9 до 14 дней, примерно в три раза больше опросов.¹
Meta
По документации Meta я не смог подтвердить, можно ли создать brand survey test для аккаунта или аудитории в Казахстане: в справке сказано, что доступность зависит от региона, а список не опубликован. Проверьте Experiments в своём аккаунте или спросите представителя Meta.
Опрос идёт на одном языке. Когда я проверял, казахского в списке поддерживаемых языков не было, русский был.⁷ Опрос только на русском в Казахстане измеряет ту часть вашей аудитории, которая читает по-русски.
TikTok
В справке сказано включать все активные кампании, чтобы контрольная группа оставалась чистой.⁸ Пороги бюджета не опубликованы. В блогах называют цифры от $25 000 до шестизначных сумм, и ни одна из них не ведёт к TikTok как к источнику.
Яндекс
Порог в тенге - это не пересчёт рублёвого (2 000 000 рублей за период), поэтому смотрите строку своей валюты. Условия изменились 12 января 2026 года, а в старых статьях до сих пор приводят суммы вдвое меньше.
Отдельный вариант Top of Mind с открытым вопросом стоит намного дороже: 33 210 000 ₸ за период и охват не менее 6 млн.⁹
Как настроить исследование
Порядок важен: большую часть этого после запуска уже не исправить. Отмечайте пункты по ходу, отметки сохраняются в этом браузере. Выполнено 0 из 7
Где ошибаются при чтении результата
Один и тот же лифт в 2 п.п., три бренда:
| Базовый уровень | Абсолютный лифт | Относительный лифт | Headroom-лифт |
|---|---|---|---|
| 5% | 2 п.п. | 40,0% | 2,1% |
| 30% | 2 п.п. | 6,7% | 2,9% |
| 60% | 2 п.п. | 3,3% | 5,0% |
Новый бренд со знанием 5% покажет «+40%» за те же 2 п.п., которые лидер рынка покажет как «+3,3%». Ни одно из чисел не ошибочно. Их просто нельзя сравнивать, и презентация с бенчмарками, где они смешаны, не сравнивает ничего. Для маленького бренда читайте абсолютный лифт. Для бренда у потолка читайте headroom-лифт.
В отчёте с разбивкой по 6 половозрастным группам и 3 креативам получается 18 срезов. При уровне доверия 90% и без реального эффекта где-либо ждите, что 1,8 из них случайно покажут «значимый» лифт. Вероятность того, что такой срез найдётся хотя бы один, равна 85%.
Лифт в одном сегменте - это гипотеза для следующего флайта
Ad recall спрашивает, помнит ли человек, что видел рекламу. Этот вопрос сдвинуть легче всего, и с брендом он связан меньше всего.
Так и пишите в отчёте: ad recall
Столбец «estimated ad recall lift (people)» в Meta Ads Manager - это модель, откалиброванная по опросам. Meta сама помечает его как оценочный и пишет, что для самого точного измерения нужен brand lift test.⁶ Холдаута в нём нет.
Это не исследование, не выдавайте его за исследование
Разные вопросы, разные аудитории, разные плейсменты опроса.
Сравнивайте два флайта на одной платформе с одним вопросом
Я искал опубликованную норму по вопросам и не нашёл ни одной с проверяемой выборкой. По данным Kantar, которые приводит WARC, дисплейная реклама даёт +2,7 п.п. знания с подсказкой, а видео с баннерами +4,8, размер базы при этом не указан.¹¹
Считайте фразу «от 4 до 8 п.п. - это норма» утверждением без источника, пока источник не покажут
Когда исследование Brand Lift - не тот инструмент
- Бюджет ниже порога. Флайт на YouTube, который тратит меньше $5 000 за первые десять дней, не проходит по условиям исследования Google. Альтернатива - собственный опрос с контрольной ячейкой, это другой метод со своей арифметикой: см. как измерять знание бренда вопросами top of mind, спонтанного знания и знания с подсказкой.
- Кампания должна продавать. Ответ в опросе - это не покупка. Для кампании, которая должна приносить заявки или заказы, холдаут сравнивают по конверсиям, а не по мнениям: см. conversion lift.
- Нужна динамика. Исследование покрывает один флайт. Знание бренда за год - это уже трекинг.
- Аудитория крошечная. B2B-кампания на несколько тысяч лиц, принимающих решения, не соберёт 2 000 ответов на группу. Никакая настройка платформы этого не изменит.
Главный вывод
Исследование Brand Lift - это небольшой рандомизированный опрос, привязанный к вашему флайту. Его результат - одна разница между двумя долями и интервал вокруг неё. Читайте абсолютный лифт и интервал. Прежде чем верить в «лифта нет», проверьте число ответов. Задавайте один вопрос и заранее решите, какой результат меняет следующий план.
Размер исследования можно прикинуть до того, как просить его у аккаунт-менеджера. Логика та же, что и для любого A/B-теста: калькулятор экспериментов на этом сайте использует ту же формулу для двух долей.
¹ Set up Brand Lift - Google Ads Help
² About Brand Lift - Google Ads Help
³ Understand your Brand Lift measurement data - Google Ads Help
⁴ Brand Lift in Display & Video 360 - Display & Video 360 Help
⁵ Meta Business Help Center: minimum budgets for brand survey tests, how holdouts work
⁶ Meta Business Help Center: brand survey test results, estimated ad recall lift
⁷ Meta Business Help Center: about brand survey tests, poll questions, best practices
⁸ TikTok Brand Lift Studies - TikTok Business Help Center
⁹ Справка Яндекс Директа: условия Brand Lift, как это работает
¹⁰ Результаты Brand Lift - Справка Яндекс Директа
¹¹ The digital brand effect - WARC, 19 March 2020
¹² Ye, Sinn, Li, Jiao (2026). Meridian GeoX: An Open-Source Framework for Precision and Efficiency in Geo Experiments. Google, 1 сентября 2026 года
Частые вопросы
Может ли небольшая кампания провести исследование Brand Lift?
Только если она проходит минимум платформы. На YouTube кампании с таргетингом на Казахстан нужно $5 000 расхода за первые 10 дней для одного вопроса, $10 000 для двух и $20 000 для трёх. Яндекс Директ требует 4 000 000 ₸ за период и охват 3 млн пользователей. Если бюджет ниже, проведите собственный опрос с контрольным регионом. Пороги проверены 5 октября 2026 года.
Почему для одной и той же кампании одна платформа показывает лифт, а другая нет?
Это разные эксперименты: разные вопросы, разные аудитории, разные плейсменты опроса и разное число ответов. Платформа, где ответов меньше, напишет «No lift detected» при том же реальном эффекте. Сравнивайте флайты внутри одной платформы, а не платформы между собой.
Является ли «estimated ad recall lift» в Meta Ads Manager исследованием Brand Lift?
Нет. Это модельная оценка, откалиброванная по опросам, и холдаута в ней нет. В документации самой Meta сказано, что для самого точного измерения ad recall нужен brand lift test.
Сколько длится исследование?
Стандартное исследование Google завершается за срок от 3 до 14 дней. Meta рекомендует не менее двух недель и допускает до 90 дней. Яндекс требует не менее 14 полных дней и рекомендует от двух до четырёх недель.
Значит ли положительный результат Brand Lift, что кампания увеличила продажи?
Нет. Он значит, что в тестовой группе больше людей дали положительный ответ в опросе. Превратилось ли это в продажи - отдельный вопрос, на него отвечает тест conversion lift или геоэксперимент.
Узнаёте свою воронку?
Две недели, фиксированный скоуп, доступы только на чтение. Находки и роадмап на 90 дней остаются у вас в любом случае.