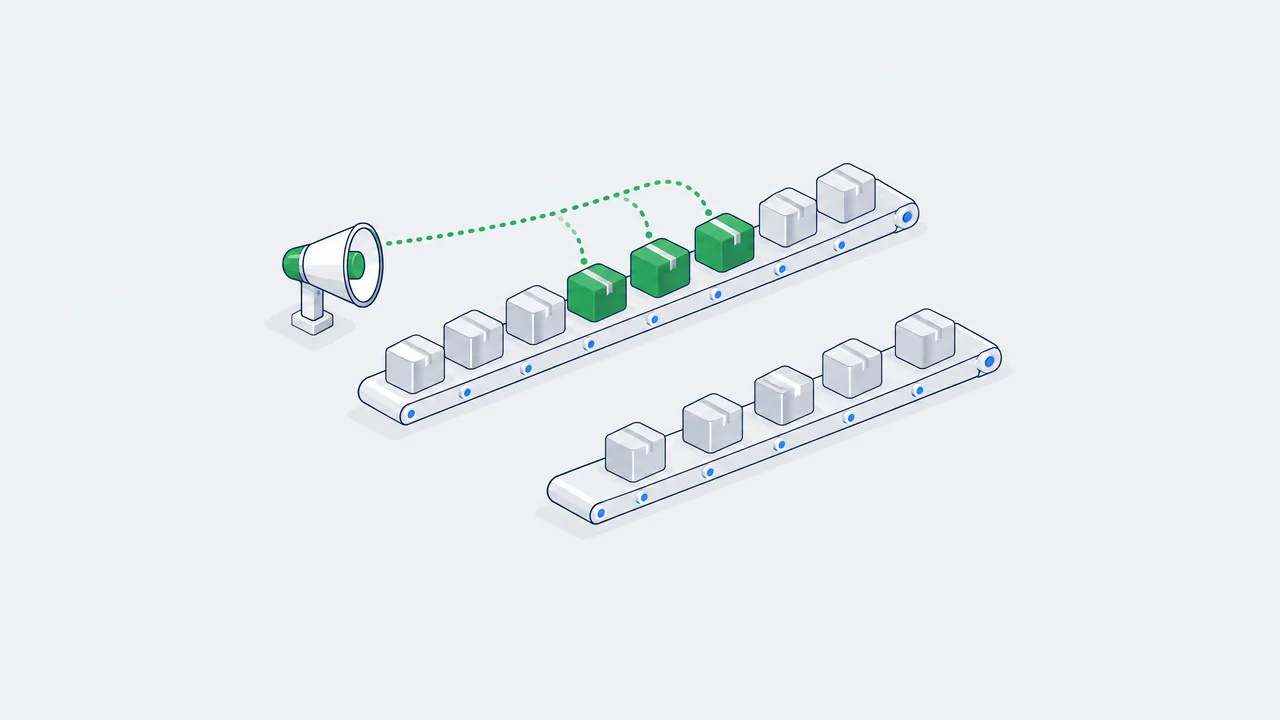
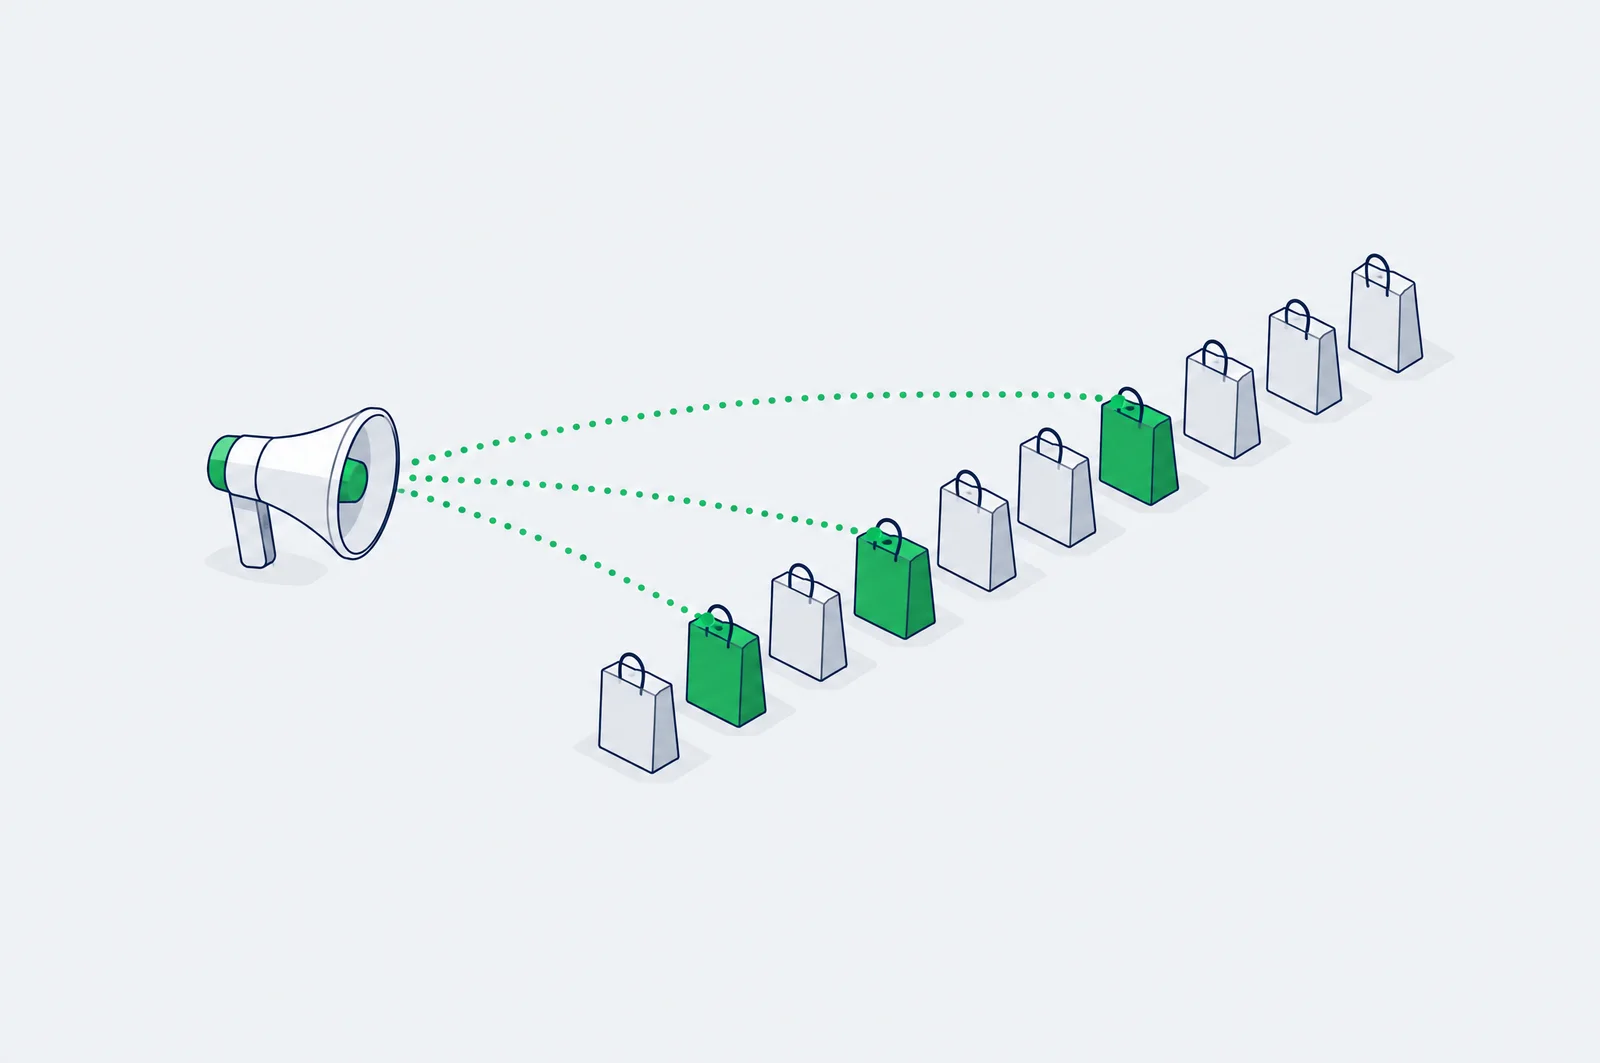
Атрибуция считает конверсии, которые случились после рекламы. Тест Conversion Lift считает те, что случились из-за неё. Платформа не показывает вашу рекламу случайной части аудитории, всё остальное идёт как обычно, а затем она сравнивает коэффициент конверсии в двух группах. В примере ниже рекламная платформа заявляет 3 000 конверсий, а эксперимент находит 900.
Сможет ли ваш аккаунт измерить такое число, зависит в основном от одного: сколько конверсий попадёт в контрольную группу. Ниже определённого количества тест пройдёт, будет стоить вам недополученных продаж и ничего не скажет.
Требования платформ ниже я проверял 5 октября 2026 года по справочным страницам каждой из них.
Почему атрибуция на это не отвечает
Атрибуция распределяет заслугу за конверсии, которые уже случились. Она не видит людей, которые сконвертировались бы и без рекламы. А именно таких людей лучше всего находят ретаргетинг и брендовый поиск.
Размер разрыва измерен. Gordon, Moakler и Zettelmeyer сравнили 663 эксперимента в Facebook с тем, что о тех же кампаниях говорили стандартные наблюдательные методы. Медианный экспериментальный лифт составил 29%, 18% и 5% для результатов верхней, средней и нижней части воронки. Метод double machine learning на тех же данных показал 83%, 58% и 24%. Propensity score matching показал 173%, 176% и 64%.¹ Blake, Nosko и Tadelis отключили поисковую рекламу eBay по брендовым запросам и не нашли от неё измеримой краткосрочной пользы.²
Meta говорит то же о собственных инструментах: lift-тест считает все конверсии в обеих группах, поэтому его цифры не совпадут с тем, что атрибутирует Ads Manager.³
Как устроен тест
Аудитория кампании
- все, кого кампания могла бы охватить
Случайное разделение
- на уровне человека, до начала показов, на весь тест
Реклама только тестовой группе
- контрольной группе её не показывают, остальные каналы работают как обычно
Все конверсии в обеих группах
- без окон атрибуции и без требования клика
Инкрементальные конверсии
- тестовая группа минус контрольная, приведённая к тому же размеру
Распределение идёт на уровне человека и не меняется весь тест.³ Всё остальное в жизни контрольной группы продолжается, включая ваши другие каналы, а конверсия засчитывается независимо от того, был ли клик.
Это intent-to-treat
Тестовая группа - это все, кому реклама могла быть показана, включая тех, кто не получил ни одного показа. Meta говорит об этом прямо.³ Вы измеряете, что кампания добавила по всей аудитории, которую ей разрешили охватить, а не эффект на тех, кто рекламу увидел.
Разделение редко бывает равным
В тесте Meta с одной ячейкой контрольная группа составляет 10% от размера тестовой, а в отчёте её масштабируют.⁴ Google позволяет задать холдаут от 1% до 50%.⁵ Target Lift Яндекса для медийных кампаний использует 90% на тест и 10% на контроль.⁹
Арифметика
Цифры условные, подобраны так, чтобы каждый шаг можно было проверить вручную:
- Тестовая группа: 900 000 человек, 5 400 конверсий. Коэффициент конверсии 0,60%.
- Контрольная группа: 100 000 человек, 500 конверсий. Коэффициент конверсии 0,50%.
- Расход: 9 000 000 ₸. Маржа с конверсии: 25 000 ₸.
- Конверсии, которые рекламная платформа атрибутировала кампании: 3 000.
Контрольная группа в девять раз меньше, поэтому сначала приведите её к размеру тестовой. Это число конверсий, которое тестовая группа дала бы без рекламы:
| Показатель | Расчёт | Результат |
|---|---|---|
| Базовые конверсии | 500 × 9 | 4 500 |
| Инкрементальные конверсии | 5 400 - 4 500 | 900 |
| Лифт | 0,60% / 0,50% - 1 | 20,0% |
| Доля конверсий тестовой группы, вызванных рекламой | 900 / 5 400 | 16,7% |
| Стоимость инкрементальной конверсии | 9 000 000 ₸ / 900 | 10 000 ₸ |
| Инкрементальный ROAS | 900 × 25 000 ₸ / 9 000 000 ₸ | 2,5 |
Теперь положите рядом отчёт по атрибуции. Платформа заявила 3 000 конверсий: атрибутированный CPA 3 000 ₸ и атрибутированный ROAS 8,3. Эксперимент говорит: 900 конверсий по 10 000 ₸ каждая и отдача 2,5.
Семь из десяти атрибутированных конверсий случились бы и так. Кампания всё ещё прибыльна при 2,5. Но это не та кампания, которую описывал дашборд, и целевой CPA, взятый с дашборда, задан в 3,3 раза щедрее, чем нужно.
Насколько это надёжно
Лифт - это отношение двух коэффициентов конверсии, а интервал для отношения чище всего строить в логарифмической шкале:
Приближение справа работает, когда коэффициент конверсии не больше нескольких процентов. Его стоит запомнить, потому что оно показывает, от чего зависит шум: от числа конверсий. Не от пользователей, не от показов, не от расхода.
Здесь SE = 0,0466 (приближение даёт 0,0467). На 500 конверсий контрольной группы приходится 92% этой дисперсии. 5 400 конверсий тестовой группы почти ничего не меняют. Такова цена маленького холдаута: он бережёт выручку, и в нём же сидит почти вся неопределённость.
Google показывает 80%-ный интервал и уверенность, равную единице минус p-value: по сути это односторонний тест на уровне 90%. Meta показывает уровень доверия в процентах и называет надёжным результат выше 90%.⁴ ⁶ В логике Google:
- Лифт: 20,0%, интервал от 13,0% до 27,4%. z = 3,91, уверенность выше 99,9%.
- Инкрементальные конверсии: 900, интервал от 623 до 1 161.
- Стоимость инкрементальной конверсии: 10 000 ₸, в диапазоне от 7 752 ₸ до 14 449 ₸.
Тот же тест в десять раз меньше: 90 000 человек и 540 конверсий против 10 000 человек и 50 конверсий. Коэффициенты конверсии те же, лифт по-прежнему 20,0%. Стандартная ошибка 0,1474, интервал от -0,7% до 45,0%, уверенность 89,2%. Истинный эффект не изменился. Тест его больше не видит.
90% и выше - сильная, от 70% до 90% - хорошая, от 50% до 70% - только направление, ниже 50% в отчёте значится как отсутствие лифта.⁶ Разберитесь со шкалой до того, как читать отчёт.
Попробуйте на своих группах:
Калькулятор Conversion Lift
Открывается с числами из примера. Подставьте свои тестовую и контрольную группы.
Лифт обнаружен. С вероятностью 90% настоящий лифт выше 13,0%.
Тест, в котором эффекта нет
Базовые 4 500 конверсий из таблицы выше выглядят как факт. На деле это 500 конверсий, умноженные на девять, и шум этих 500 умножен на девять вместе с ними.
Чтобы увидеть, к чему это приводит, я смоделировал 4 000 тестов кампании, которая ничего не меняет: обе группы конвертируются в 0,50%, в тестовой 900 000 человек, в контрольной 100 000. Для каждого теста «инкрементальные конверсии» посчитаны точно так же, как выше.
Правильный ответ в каждом из этих тестов - ноль. У измеренного ответа стандартное отклонение 210 конверсий, и только 65,3% тестов попадают в пределы 200 конверсий от нуля. Два способа решить, лифт это или нет:
| Тест | «Лифт» там, где его нет | Сколько должно быть |
|---|---|---|
| Интервал по логарифму отношения из раздела выше | 9,9% | 10% |
| Упрощение: 4 500 - это «база», далеко ли от неё тестовая группа? | 34,4% | 10% |
Упрощение считает приведённую базу известным числом, и тогда остаётся только счётный шум вокруг 4 500: стандартное отклонение 67. Настоящее - 210, втрое шире, и почти вся разница приходит из маленькой контрольной группы. Слайд «ожидали 4 500, получили 4 700» делает именно эту ошибку. Каким бы инструментом вы ни считали, проверьте, что неопределённость контрольной группы попала в интервал.
Сколько конверсий нужно
Если развернуть формулу стандартной ошибки, получится число конверсий в контрольной группе, нужное, чтобы обнаружить заданный лифт. Односторонний уровень 90% и мощность 80% дают zα + zβ = 2,1232; k - размер тестовой группы относительно контрольной:
| Лифт, который нужно обнаружить | 50/50: конверсии в контроле | 50/50: все конверсии | Холдаут 10%: конверсии в контроле | Холдаут 10%: все конверсии |
|---|---|---|---|---|
| 5% | 3 698 | 7 580 | 2 095 | 21 884 |
| 10% | 948 | 1 990 | 547 | 5 956 |
| 20% | 249 | 547 | 149 | 1 749 |
| 30% | 116 | 267 | 72 | 903 |
Лифт вдвое меньше - конверсий вчетверо больше
Кампании нижней части воронки с истинным лифтом 5% нужны тысячи конверсий в контрольной группе. У большинства аккаунтов столько не набирается за одно окно теста.
За маленький холдаут платят временем
Холдауту 10% нужно примерно втрое больше конверсий в сумме, чем равному разделению. Он обходится меньшим числом недополученных продаж в день и большим числом дней.
Считайте конверсии, а не людей
Тесту на редком событии (выданный кредит, годовая подписка) не хватает мощности почти при любом размере аудитории. Lewis и Rao показали это на большом масштабе: в 25 экспериментах с расходом $2,8 млн медианный доверительный интервал для ROI был шире 100 п.п.⁷
Входные требования платформ - это та же арифметика. Google не показывает результаты при расходе ниже $5 000 или если в тестовой группе меньше 150 конверсий, а в контрольной меньше 65; результаты с уверенностью ниже 90% показываются только при расходе выше $5 000 и более чем 1 000 конверсий.⁶ Эти 65 стоят рядом со строкой 30% в таблице.
Охват и к чему именно относится лифт
Допустим, показ реально получили только 60% тестовой группы: 540 000 из 900 000. Все 900 инкрементальных конверсий пришли от этих людей, это 0,167 п.п. на охваченного человека. По всей тестовой группе это 0,10 п.п.
Число инкрементальных конверсий в обоих случаях одно и то же, и именно оно вместе со стоимостью нужно для решения по бюджету. Меняется процент: 40% тестовой группы, не видевшие рекламу, добавляют конверсии в обе стороны сравнения и не добавляют эффекта, поэтому лифт в процентах сжимается и его труднее обнаружить.
Метод «ghost ads» Johnson, Lewis и Nubbemeyer создан именно для этого: он определяет людей в контрольной группе, которым реклама была бы показана. Авторы сообщают о той же точности при затратах на порядок ниже, чем у дизайнов intent-to-treat.⁸ Если кампания охватывает малую часть своей доступной аудитории, для платформенного lift-теста она плохой кандидат.
Что требует каждая платформа
| Meta | Google Ads, по пользователям | TikTok | Яндекс Директ, Target Lift | |
|---|---|---|---|---|
| Как получить доступ | Experiments, Create test, Conversion Lift. Кнопка неактивна, если аккаунт не проходит по требованиям³ | Через представителя Google, который ведёт аккаунт⁵ | Через представителя, который ведёт аккаунт¹⁶ | Только медийные кампании, включается до первого показа⁹ |
| Входные требования | Кампания, запущенная за последний год, с расходом не менее $5 000 и 500 конверсиями; Conversions API с event match quality выше 5³ | Не менее 1 000 конверсий и бюджет кампании не менее $5 000⁵ | Минимальный расход различается; не опубликован¹⁶ | От 1 до 5 целей; кампания не короче 7 дней⁹ |
| Разделение | Контроль составляет 10% от тестовой группы в тесте с одной ячейкой⁴ | Холдаут от 1% до 50%⁵ | Тестовая и контрольная группы¹⁶ | 90% тест, 10% контроль⁹ |
| Длительность | Рекомендуется не менее 28 дней³ | Не менее 7 дней, рекомендуется больше 14⁵ | Не опубликована | Результат примерно через 10 дней после окончания кампании⁹ |
| Что в отчёте | Инкрементальные конверсии, стоимость инкрементальной конверсии, лифт продаж, лифт ROAS, уровень доверия⁴ | Инкрементальные конверсии, относительный лифт, инкрементальная ценность, инкрементальные CPA и ROAS, интервалы⁶ | Инкрементальные конверсии, абсолютный и относительный лифт, стоимость инкрементальной конверсии, iROAS, уровень доверия¹⁶ | Прирост целевых действий; при отсутствии заметного лифта может не показываться ничего⁹ |
Meta
Для тестов с несколькими ячейками (две стратегии, у каждой свой холдаут) по-прежнему нужен представитель Meta. Результаты могут начать появляться после 100 конверсионных событий, но это порог отображения, а не рекомендация по размеру выборки.⁴
Одна старая страница справки до сих пор утверждает, что холдаут-тесты в Experiments приостановлены в апреле 2021 года; она противоречит актуальным страницам и выглядит устаревшей. По документации я не смог подтвердить, доступен ли самостоятельный запуск теста аккаунтам в Казахстане: доступ ограничен расходом, конверсиями и качеством сигнала, списка стран нет. Откройте Experiments в своём аккаунте и посмотрите, активна ли кнопка.
Требования резко снизились в 2025 году, когда Google перевёл lift-исследования на байесовский метод, который использует историю самой кампании как априорное распределение. По словам самого Google, исследование, которое стоило до $100 000, теперь требует минимум $5 000.¹⁰
Есть ещё вариант по географии, о нём ниже. Ни тот, ни другой не доступен для самостоятельного запуска в каждом аккаунте.
Яндекс
Target Lift измеряет медийные кампании. Для поисковых и performance-кампаний я не нашёл документированного продукта для conversion lift: A/B-эксперименты в Директе сравнивают настройки кампаний между собой, холдаута без рекламы в них нет. Для таких кампаний единственный путь - гео-тест, который вы проводите сами.
Когда делить приходится по географии
Если рандомизировать людей нельзя (для канала нет платформенного теста, каналов несколько сразу, продажи офлайн), рандомизируют места: в одних регионах реклама идёт, в других нет, и разница в продажах между ними с поправкой на обычное поведение этих регионов и есть лифт.
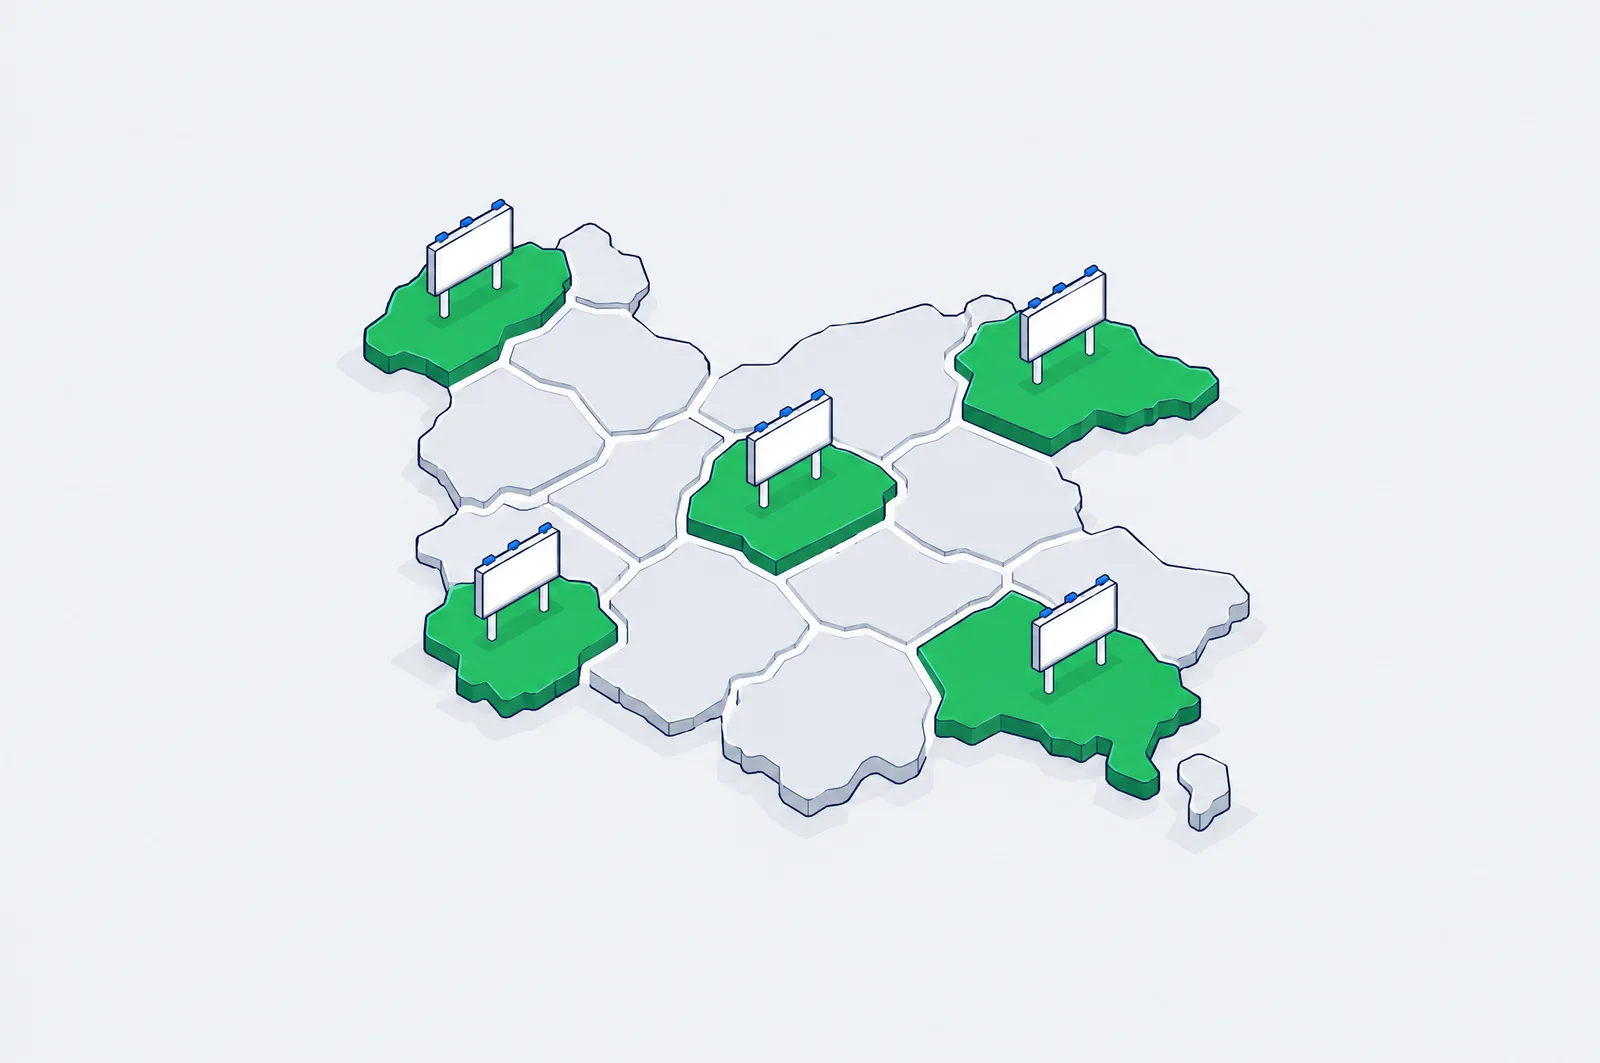
Регионы с продажами по дням
- предтестовый период минимум втрое длиннее теста
Случайное распределение внутри страт
- крупные регионы с крупными, небольшие с небольшими
Регрессия на предтестовом периоде
- тестовые регионы предсказываются по контрольным
Кампания только в тестовых регионах
Контрфактические продажи
- сколько тестовые регионы продали бы без рекламы
Плацебо-тест
- тот же анализ на распределениях, где рекламы не было
Исследование Google по географии делает это на собственных географических единицах, подобранных так, чтобы ограничить перетекание эффекта между регионами, и показывает инкрементальный ROAS с доверительным интервалом. Google предупреждает, что бюджет обычно выше, чем для исследования по пользователям, и что кампании должны быть нацелены на одну страну.¹¹
Чтобы провести такой тест самостоятельно, есть три открытых инструмента: Meridian GeoX от Google, выпущенный в 2026 году вместе со статьёй, на которую опирается этот раздел, GeoLift от Meta (синтетический контроль) и CausalImpact от Google (байесовские структурные временные ряды).¹⁸ ¹² ¹³
Контрфактический прогноз
Самый простой метод, который выдерживает проверку, - регрессия по времени (time-based regression). Сложите дневные продажи по тестовым регионам и отдельно по контрольным. На днях до кампании постройте прямую, которая предсказывает одно по другому:
Во время кампании контрольные регионы продолжают давать данные. Подставьте их продажи в построенную прямую и получите контрфактический прогноз: сколько тестовые регионы продали бы без рекламы. Эффект - это разрыв между фактом и прогнозом, просуммированный по дням кампании:
Синтетический контроль и синтетическая разность разностей строят тот же прогноз из взвешенной смеси контрольных регионов вместо их простой суммы. В GeoX есть все три метода, и в бенчмарке авторов лучшей в целом оказалась регрессия по времени на стратифицированном дизайне.¹⁸
Где гео-тесты ошибаются: проверка значимости
Дневные продажи - не независимые наблюдения. Слабая неделя остаётся слабой, каждый понедельник похож на предыдущий. t-тест по дневным разрывам считает 30 дней кампании тридцатью независимыми наблюдениями и показывает намного больше уверенности, чем есть в данных.
Статья о GeoX измеряет, насколько. В 38 400 смоделированных A/A-экспериментах на данных 192 рекламодателей, где эффекта не было ни в одном, t-тест давал ложные срабатывания более чем в десять раз чаще номинальных 5%.¹⁸ Замена - плацебо-тест. Весь анализ повторяют на множестве фиктивных распределений, составленных по тому же правилу, по которому выбирали настоящие тестовые регионы, но без рекламы. Каждое даёт эффект, который целиком состоит из шума, а p-value - это доля таких эффектов, не менее экстремальных, чем настоящий:
Авторы рекомендуют не меньше 100 плацебо-распределений и делят каждый эффект на ошибку прогноза в предтестовом периоде, чтобы шумная плацебо-группа и спокойная сравнивались в одном масштабе.¹⁸
Я воспроизвёл это сравнение на синтетическом рынке: 20 регионов, 6 из них тестовые, 60 дней до теста и 30 дней теста, у продаж общий недельный цикл и зависимость от предыдущего дня. 1 000 тестов, эффекта нет ни в одном.
| Тест | Ложные эффекты при пороге 10% | При пороге 5% |
|---|---|---|
| t-тест по дневным разрывам | 48,7% | 40,6% |
| Плацебо-тест, 200 фиктивных распределений | 10,5% | 4,3% |
Симуляция моя, и её цифры описывают этот синтетический рынок, а не ваш. Направление - вывод статьи: на дневных рядах учебный тест не осторожное приближение, он производит эффекты из шума.
Что гео-тест способен увидеть
Наименьший лифт, который тест может обнаружить, следует из стандартной ошибки эффекта, а её плацебо-прогоны дают ещё до того, как потрачены деньги:
Поэтому анализ мощности - это та же процедура на данных прошлого квартала. Чем лучше контрольные регионы предсказывают тестовые до кампании, тем меньше стандартная ошибка. В бенчмарке авторов плацебо-группы, составленные по правилу самого дизайна, а не случайно, снизили средний минимальный обнаруживаемый эффект на 26,8%.¹⁸
На синтетическом рынке выше плацебо-тест нашёл настоящий лифт в 3% в 82,0% прогонов, а лифт в 5% - в 98,8%. Реальные региональные продажи грубее симуляции, поэтому до того, как доверять любой из этих цифр, прогоните плацебо-анализ на своей истории.
Рекомендации GeoLift хорошо возвращают к реальности: не менее 20 географических единиц, предтестовый период в четыре-пять раз длиннее теста и не менее 15 дней теста на дневных данных.¹² Статья о GeoX требует предтестовых данных минимум втрое длиннее теста, а при сезонных продажах больше.¹⁸
В Казахстане это выполняется впритык. В стране 20 единиц первого уровня (17 областей плюс Алматы, Астана и Шымкент), и они далеко не равны по размеру. Это довод в пользу стратификации: сгруппируйте регионы с похожим объёмом продаж и сезонностью и рандомизируйте внутри каждой группы, чтобы крупнейший город не оказался против самого маленького региона.¹⁸ Гео-тест здесь реален для продукта с ощутимым объёмом в регионах. Насколько малый лифт он увидит - эмпирический вопрос к вашей истории продаж, и плацебо-анализ отвечает на него до запуска. И он протекает. Человек, который увидел рекламу в тестовом регионе и купил в контрольном, уменьшает измеренную разницу.¹¹
Настройка теста
Отмечайте пункты по ходу; отметки сохраняются в этом браузере. Выполнено 0 из 6
По первому пункту техническая часть разобрана в статьях Meta CAPI и CAPIG и как связать рекламу с продажами в отделениях.
Как читать результат
«Лифт 20%» с интервалом от 13% до 27% - это результат. «Лифт 20%» с интервалом от -1% до 45% - это догадка, к которой приложили число.
Meta называет это «similar performance» и определяет как отсутствие значимой разницы.¹⁵ Google при низкой уверенности пишет, что лифт не обнаружен. Ни то, ни другое не означает, что реклама ничего не дала. Сначала сверьте число конверсий в контрольной группе с таблицей.
Коэффициент 0,30 означает, что 3 000 ₸ по атрибуции - это примерно 10 000 ₸ в реальности. Он относится к этой кампании, этой аудитории, этому сезону и этому уровню расхода. У проспектинга и ретаргетинга коэффициенты разные. У октября и декабря тоже.
Lift-тест показывает, что добавила вся кампания. Он не показывает, что добавили последние 20% расхода. Для этого нужны два уровня расхода как отдельные ячейки, у каждой свой холдаут.
Результат lift-теста - самые сильные входные данные, которые может получить модель медиамикса. Документация Google Meridian считает эксперименты лучшей основой для априорных распределений ROI и предупреждает, что временное окно эксперимента и то, что он оценивает, могут отличаться от модельных.¹⁷ Используйте его для калибровки, а не для перезаписи.
Когда тест запускать не стоит
- В контрольной группе будет меньше сотни конверсий. Возьмите более частое событие ближе к верху воронки и примите, что это более слабый прокси, или подождите, пока объём вырастет.
- У кампании нет конверсии, которую можно считать. Флайт на узнаваемость измеряют опросом: см. исследования Brand Lift.
- Вы тестируете два креатива. Это A/B-тест. Lift-тест сравнивает рекламу с её отсутствием.
- Охват составляет малую долю доступной аудитории. Размывание, описанное выше, съедает сигнал.
Итог
Тест Conversion Lift заменяет вопрос «сколько конверсий соприкоснулось с рекламой» вопросом «скольких не было бы без неё». Ответ - это отношение с интервалом, а ширину интервала задаёт число конверсий в меньшей группе. Рассчитывайте размер теста от этого числа, зафиксируйте правило решения до запуска и читайте результат как диапазон.
Чтобы проверить размер выборки для равного разделения, возьмите калькулятор экспериментов на этом сайте: он использует ту же логику сравнения двух долей. Про брендовую сторону той же кампании: исследования Brand Lift и опросы знания бренда.
¹ Gordon, Moakler, Zettelmeyer (2023). Close Enough? A Large-Scale Exploration of Non-Experimental Approaches to Advertising Measurement. Marketing Science 42(4)
² Blake, Nosko, Tadelis (2015). Consumer Heterogeneity and Paid Search Effectiveness. Econometrica 83(1)
³ Meta Business Help Center: about Conversion Lift, creating a test, lift and attribution
⁴ Meta Business Help Center: Conversion Lift results
⁵ Users-based Conversion Lift - Google Ads Help
⁶ Google Ads Help: certainty of lift, Bayesian methodology for lift
⁷ Lewis, Rao (2015). The Unfavorable Economics of Measuring the Returns to Advertising. Quarterly Journal of Economics 130(4)
⁸ Johnson, Lewis, Nubbemeyer (2017). Ghost Ads: Improving the Economics of Measuring Online Ad Effectiveness. Journal of Marketing Research 54(6)
⁹ Справка Яндекс Директа: как работает Target Lift, условия, результаты
¹⁰ Marketing experimentation and incrementality testing - Think with Google, February 2026
¹¹ Google Ads Help: geography-based Conversion Lift, its results
¹² Meta Open Source: GeoLift, best practices
¹³ CausalImpact - Google
¹⁴ Meta Business Help Center, on promotions during a lift test
¹⁵ Meta Business Help Center, on test results with similar performance
¹⁶ About Conversion Lift Study - TikTok Business Help Center
¹⁷ ROI priors and calibration - Google Meridian
¹⁸ Ye, Sinn, Li, Jiao (2026). Meridian GeoX: An Open-Source Framework for Precision and Efficiency in Geo Experiments. Google, 1 сентября 2026 года. Код: github.com/google/meridian-geox
Частые вопросы
Тест Conversion Lift - это то же самое, что A/B-тест?
Нет. A/B-тест сравнивает две версии объявления или страницы. Lift-тест сравнивает рекламу с её отсутствием: одной случайной группе кампания может быть показана, а другую держат в холдауте.
Почему lift-тест показывает меньше конверсий, чем Ads Manager?
Атрибуция считает конверсии, которые последовали за рекламой. Lift-тест считает конверсии, которых не было бы без рекламы: он вычитает то, что контрольная группа сделала и так. Второе число обычно меньше.
Каким должен быть размер холдаута?
Достаточным, чтобы набрать нужное тесту число конверсий в контрольной группе. Чтобы обнаружить лифт 10%, нужно около 547 конверсий в контроле при холдауте 10% или 948 в каждой группе при равном разделении. Больший холдаут сокращает тест и отнимает больше продаж в день.
Какой коэффициент инкрементальности считать хорошим?
Универсального бенчмарка нет. В исследовании 663 экспериментов в Facebook медианный экспериментальный лифт составил 29% для результатов верхней части воронки, 18% для средней и 5% для нижней, а стандартные наблюдательные методы завысили все три. Измеряйте свой, по каждому типу кампаний.
Можно ли провести тест Conversion Lift в Яндекс Директе?
Только для медийных кампаний, через Target Lift с разделением 90/10. Для поисковых и performance-кампаний документированного холдаута без рекламы нет, поэтому остаётся гео-тест, который вы проводите сами. Проверено 5 октября 2026 года.
Узнаёте свою воронку?
Две недели, фиксированный скоуп, доступы только на чтение. Находки и роадмап на 90 дней остаются у вас в любом случае.